
Datenmaskierung erklärt: Techniken, Anwendungsfälle und Grenzen
Oct 20, 2026
Datenmaskierung begrenzt unnötige Offenlegung, wenn Teams sensible Produktionswerte in Tests, Analysen und Freigabe-Workflows kopieren. Sie ersetzt diese Werte durch realistische Ersatzwerte, doch schwache Implementierungen erlauben weiterhin Rückschlüsse, Verknüpfungen oder Rückgängigmachung. Effektive Programme wählen Techniken basierend auf der nachgelagerten Nutzung und prüfen jede Ausgabe gegen den vorgesehenen Workflow.
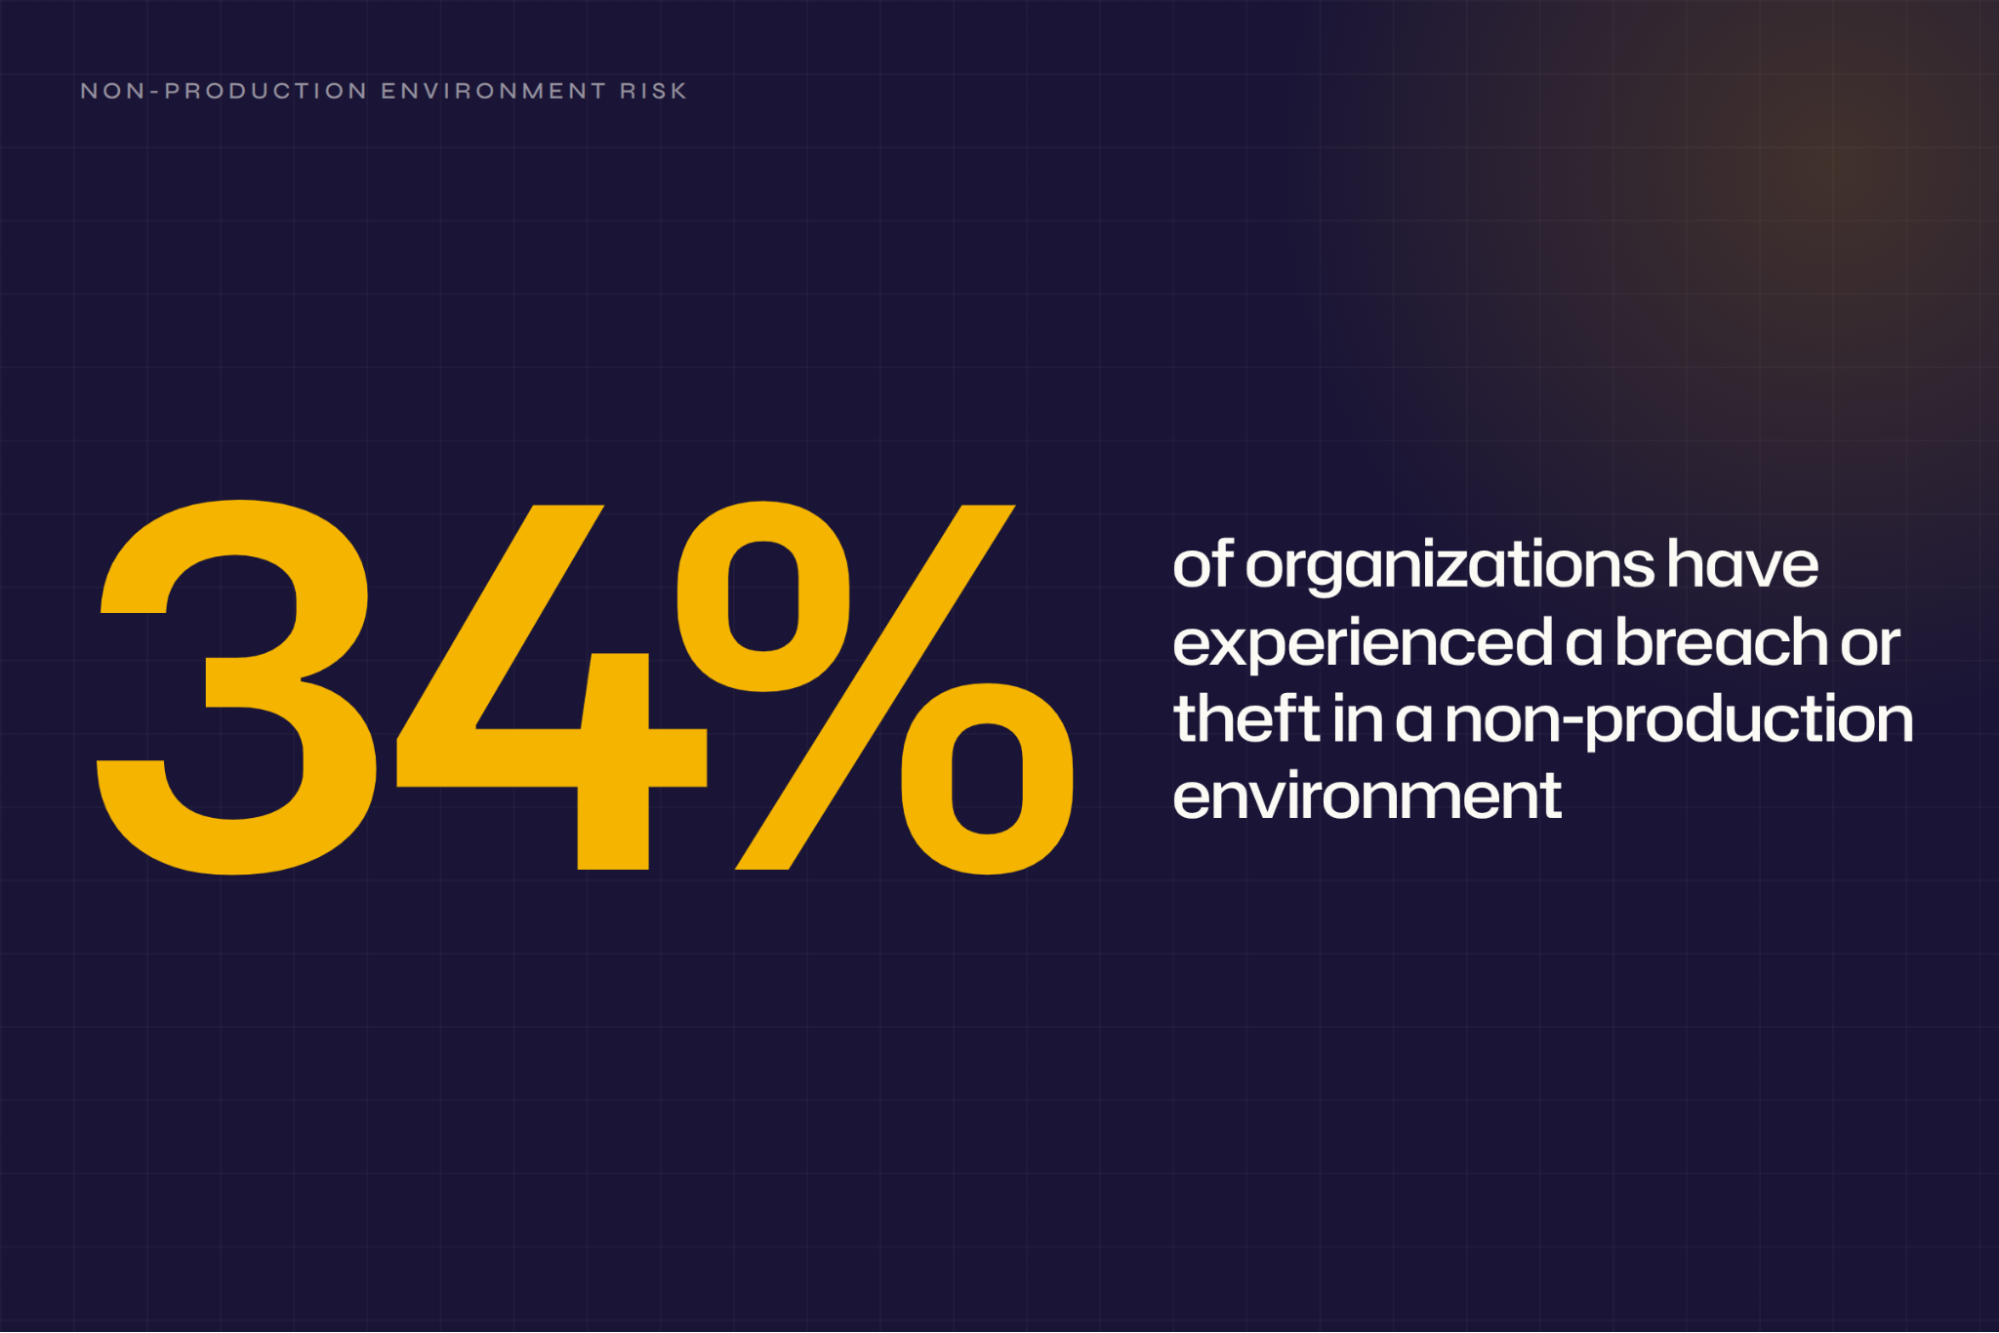
Eine Datenmaskierungspflicht besteht in 99 % der Organisationen, doch 84 % erlauben weiterhin Ausnahmen, und 34 % haben laut Perforce Delphix’ Bericht zum Stand von Daten-Compliance und Sicherheit 2026 eine Sicherheitsverletzung oder einen Diebstahl in einer Nicht-Produktionsumgebung erlebt.
Diese Kluft zwischen Richtlinie und Praxis schwächt sonst wirksame Kontrollen, denn eine formal erfüllte Anforderung auf dem Papier sagt nichts darüber aus, ob die gewählte Technik die Daten schützt.
Maskierte Daten können durch den umgebenden Kontext weiterhin sensible Informationen offenbaren. Ein Benutzer mit Abfragezugriff kann die zugrundeliegenden Werte hinter einer dynamischen Maske erschließen indem er Ergebnisse verschiedener Abfragen vergleicht.
Der richtige Ansatz berücksichtigt diese Schwächen, bevor Teams Kopien in niedrigeren Umgebungen erstellen oder maskierte Produktionsansichten freigeben, und beginnt damit, den Maskierungstyp und die Technik an die Anforderungen jedes Feldes nach Verlassen der Produktion anzupassen.
Was ist Datenmaskierung?
Datenmaskierung ist eine Schutztechnik, die sensible Werte ersetzt durch realistische, nicht sensible Ersatzwerte, sodass die Daten nutzbar bleiben, ohne echte Werte preiszugeben. Ein maskiertes Feld behält Format und Datentyp bei, sodass eine maskierte Sozialversicherungsnummer weiterhin eine neunstellig Prüfung besteht und ein maskiertes Gehalt sich wie eine Zahl verhält, die ein Bericht summieren kann.
Diese Kombination, ein Ersatz, der wie das Original aussieht und sich so verhält, ohne zu verraten, was das Original war, ermöglicht es Entwicklungs-, Analyse- und Supportteams, mit produktionsnahen Daten zu arbeiten, ohne der echten Daten ausgesetzt zu sein.
Maskierung unterscheidet sich von Datenverschlüsselung, die jeder mit dem Entschlüsselungsgeheimnis rückgängig machen kann, und von Datenredaktion, die den Wert vollständig löscht und Tester ohne brauchbaren Ersatz zurücklässt.
Warum ist Datenmaskierung wichtig?
Maskierung unterstützt verschiedene operative und Compliance-Ziele, wenn Teams sie auf die richtigen Daten und Umgebungen anwenden:
- Nicht-produktive Umgebungen sind keine Belastung mehr: Entwicklungs-, Test- und Qualitätssicherungsteams (QA) erhalten realistische Daten, während in der Produktion personenbezogene Daten (PII) nicht in Datenbank-Dumps gelangen.
- Compliance-Programme erhalten Nachweise, auf die sie verweisen können: Maskierung entspricht direkt den Pseudonymisierungs- und Datenminimierungskontrollen, die Prüfer bereits unter wichtigen Datenschutz- und Zahlungsregelungen anerkennen.
- Analytics und KI entwickeln sich schneller: Analysten und Modelle lernen aus realistischen Mustern, während identifizierbare Daten geschützt bleiben.
- Umgebungen mit geringerer Vertrauensstufe haben einen kleineren Schadensradius: Wenn jemand Zugriff auf das Testsystem eines Anbieters oder den QA-Cluster einer Organisation erhält, bieten korrekt maskierte Daten keine echten Informationen zum Mitnehmen.
- Support-Teams beheben Probleme, ohne Rohdaten zu berühren: Ein Helpdesk-Mitarbeiter kann das Kundenproblem an einer maskierten Kopie nachvollziehen, statt das echte Konto zu öffnen.
Welche Arten der Datenmaskierung gibt es?
Datenmaskierung nimmt je nach Zeitpunkt und Ort unterschiedliche Formen an. Die Wahl des richtigen Typs bestimmt, wer den unmaskierten Wert sieht und wie viele maskierte Kopien der Daten in der Umgebung verteilt sind.
Statisches Datenmaskieren
Statisches Maskieren ist der Standard für alles, was Ihr Team weitergibt. Sie ziehen eine Kopie aus der Produktion, maskieren sie dauerhaft und senden sie an Entwicklung, Test oder QA. Das Ergebnis ist unwiderruflich, da die Originalwerte aus der Kopie nicht wiederhergestellt werden können und kein Entschlüsselungsschlüssel existiert, der geschützt werden müsste.
Microsoft stellte 2018 statisches Datenmaskieren in SQL Server Management Studio (SSMS) 18 vor, entfernte es jedoch vor der allgemeinen Verfügbarkeit (GA). Ein Microsoft-Mitarbeiter bestätigte in einer Antwort in der Tech Community im Februar 2023, dass es nicht auf der Roadmap steht.
Die zugrundeliegende Technik bleibt bei den meisten ETL- und Datenbank-Migrationstools standardisiert, unabhängig davon, was ein einzelner Anbieter nativ unterstützt.
Das schwierigere Problem ist die referenzielle Integrität, da das Maskieren einer Kunden-ID in einer Tabelle erfordert, denselben Ersatzwert in allen anderen Tabellen zu verwenden, die damit verknüpft sind, sonst brechen die Verknüpfungen stillschweigend zusammen.
Dynamische Datenmaskierung
Dynamisches Datenmaskieren (DDM) unterstützt Umgebungen, in denen Teams direkt auf den Produktionsdatensatz zugreifen müssen, anstatt mit einer separaten Kopie zu arbeiten. Es maskiert sensible Werte in Abfrageergebnissen für nicht privilegierte Benutzer, während die gespeicherten Daten unverändert bleiben.
Ein Support-Mitarbeiter, der in der Produktion abfragt, sieht XXXX an der Stelle, wo die Sozialversicherungsnummer (SSN) steht, während ein Administrator mit erweiterten Rechten den echten Wert sieht. Dieser Ansatz hält eine gesicherte Produktionskopie statt einer separaten maskierten, aber jeder mit erweiterten Datenbankrollen und jeder, der eine ausreichend enge Abfrage erstellen kann, erhält weiterhin den Originalwert.
Eine Abfrage wie WHERE Salary > 99999 and Salary < 100001 bestätigt ein maskiertes Gehalt, ohne dass die Maske je sichtbar wird, weshalb DDM eher für versehentliche Offenlegung als für gezielte Angriffe geeignet ist.
Es verhindert, dass eine beiläufige Abfrage einen unzulässigen Wert zurückgibt, aber nichts hindert jemanden daran, die Abfrage absichtlich so einzuschränken, bis die Maske trotzdem die Antwort preisgibt.
Netwrix DSPM findet und schützt sensible Daten in lokalen, hybriden und Cloud-Umgebungen. Fordern Sie eine Demo an.
Sofortiges und deterministisches Maskieren
Das On-the-fly-Masking, auch In-Flight-Masking genannt, läuft innerhalb eines Migrations- oder ETL-Jobs (Extrahieren, Transformieren, Laden), der aus der Quelle liest und nur maskierte Werte ins Ziel schreibt, sodass jede Zwischenkopie geschützte Werte enthält. Diese Pipelines erfordern Durchsatzplanung bei großen Datenmengen.
Deterministisches Maskieren ordnet dieselbe Eingabe stets derselben Ausgabe zu – über Tabellen, Datenbanken und Jobs hinweg, sodass Joins und referenzielle Beziehungen erhalten bleiben.
Datenmaskierungstechniken
Teams sollten nur die Techniken wählen, die ihre Arbeitsabläufe benötigen. Ordnen Sie jede Technik dem zu, was das Feld nach der Produktion macht.
Ersatz
Substitution tauscht einen echten Wert gegen einen realistisch gefälschten aus einer Nachschlagetabelle oder einem Wörterbuch aus. Substitution kann auch deterministisch laufen, sodass dieselbe Kunden-ID jedes Mal denselben gefälschten Wert erhält und Verknüpfungen zwischen HR-, Gehalts- und Leistungsdatenbanken funktionieren.
Diese Nachschlagetabelle ist auch die Schwachstelle. Wenn sie durchsickert, offenbart sie die gesamte Original-zu-maskierte Zuordnung, und die OWASP-Richtlinien listen das Speichern kryptografischer Geheimnisse oder Zuordnungsdaten neben pseudonymisierten Daten als unsicheres Muster.
Verwenden Sie Substitution in Entwicklungs- und QA-Datensätzen, wenn Tester Namen, Adressen und Kontonummern benötigen, die wie echte aussehen und sich so verhalten, da Formatvalidierung, UI-Darstellung und Tabellenverknüpfungen weiterhin funktionieren.
Mischen
Das Mischen ordnet Spaltenwerte neu an, sodass jede Zeile den Wert einer anderen Zeile erhält. Oracle Data Safe weist darauf hin, dass das Mischen die Gesamtdatenverteilung der Spalte bewahrt, und die Gruppenmischvariante von Oracle tauscht Werte nur innerhalb einer Kategorie, etwa Gehälter innerhalb einer Berufsgruppe. Jeder echte Wert bleibt im Datensatz, jedoch in einer anderen Zeile, sodass Teams entscheiden müssen, ob dies ausreichend Schutz bietet.
Bleiben verwandte Quasi-Identifikatoren wie Postleitzahl, Geburtsdatum und Geschlecht ungemischt oder werden separat gemischt, kann jemand Zeilen wieder verknüpfen. Mischen Sie sie stattdessen gemeinsam und verwenden Sie die Technik nur für Analysedatensätze, bei denen die Verteilung einer Spalte wichtiger ist als welcher Datensatz welchen Wert enthält.
Schwärzung und Löschung
Die Schwärzung entfernt oder löscht einen Wert vollständig. Die Standardmaske von SQL Server verwandelt beispielsweise Zeichenketten in XXXX und Zahlen in 0. Eine Standardmaske ist einfach einzurichten, zerstört jedoch die Nutzbarkeit des Feldes für Tests oder Analysen. Verwenden Sie sie nur für Felder ohne weitere Verwendung in einer niedrigeren Umgebung, wie vollständige Sozialversicherungsnummern, vollständige Kartennummern oder eine Freitext-Notizspalte, die niemand sehen muss.
Tokenisierung und formatwahrende Verschlüsselung
Die Tokenisierung ersetzt eine primäre Kontonummer (PAN) durch ein Ersatz-Token, während die formatwahrende Verschlüsselung (FPE) das Format und die Länge des Chiffretexts bewahrt. Beide sind per Design reversibel, was das Risikomodell ändert. Vault-basierte Tokens nutzen eine Lookup-Tabelle; vaultlose Tokens werden kryptografisch aus der PAN abgeleitet, sodass das System nur ein kryptografisches Geheimnis speichert.
Wer das kryptografische Geheimnis oder den Tresor besitzt, kann jeden geschützten Wert wiederherstellen. Daher bestimmt die Verwaltung dieser Geheimnisse und Tresore das Restrisiko, und das PCI SSC warnt, dass eine Kompromittierung des Datentresors das gesamte Tokenisierungssystem gefährden könnte.
Wählen Sie Tokenisierung oder FPE, wenn Zahlungs- und Finanzdaten ihr ursprüngliches Format behalten oder für einen autorisierten Ablauf reversibel bleiben müssen; die Trennung eines reinen Token-Systems von der Tokenisierungsumgebung kann es sogar außerhalb des PCI-DSS Karteninhaberdatenbereichs verschieben.
Rauschzugabe und Varianz
Rauschzugabe fügt einem Zahlenwert zufällig eine Menge hinzu oder multipliziert ihn, sodass die Gesamtsumme erhalten bleibt, während einzelne Werte verschwimmen. Numerische Varianz bei Informatica, einem Salesforce-Unternehmen, funktioniert so.
Informatica-Dokumente zeigen, dass ein Eingangswert von 66 mit einer symmetrischen 50%-Varianz zwischen 33 und 99 liegt. Verwenden Sie Rauschzugabe bei Berichten und Modelltraining, wenn Trend oder Verteilung wichtiger sind als einzelne Datensätze, z. B. Gehaltsstufen, Altersgruppen und Transaktionsbeträge.
Wo die Datenmaskierung versagt
Maskierung verringert die Exposition, ist aber keine vollständige Lösung für Datenrisiken allein. Jede unten genannte Einschränkung bestimmt, wie viel zusätzliche Kontrolle ein Maskierungsprogramm noch benötigt – von dem, was passiert, wenn jemand die maskierten Daten mit anderen verknüpft, bis hin zur Frage, ob Regulierungsbehörden das Ergebnis als sicher ansehen.
Risiko der Re-Identifikation bei Kombination von Datensätzen
Jeder, der einen zweiten Datensatz besitzt, kann maskierte Daten durch Verknüpfung aufdecken. Kombinationen wie Postleitzahl, Geschlecht und Geburtsdatum können Personen identifizieren, wenn ein Angreifer geeignete Zusatzdaten hat.
Ein arXiv-Preprint vom Februar 2026, Groß angelegte Online-Deanonymisierung mit LLMs, berichtete bis zu 68 % Trefferquote bei 90 % Präzision für LLM-basierte Re-Identifikation pseudonymer Online-Nutzer, gegenüber fast 0 % für die beste Nicht-LLM-Methode.
Die Studie bezog sich auf Online-Profile statt auf maskierte Tabellen, doch der Mechanismus ist derselbe: übrig gebliebene Attribute werden mit externen Daten abgeglichen.
Es schützt die Originaldaten im Ruhezustand nicht
Maskierung erzeugt eine sichere Kopie oder Ansicht. Das Produktionssystem mit den echten Werten benötigt weiterhin eigene Zugriffskontrollen, Verschlüsselung und Sichtbarkeit.
Manche Techniken sind nur so stark wie ihr schwächstes Glied
Eine Lookup-Tabelle, ein Token-Tresor oder ein Hash-Verfahren können alle Zuordnungen auf einmal offenlegen. Kleine oder vorhersehbare Eingabemengen erlauben Angreifern zudem, Kandidatenwerte zu testen, bis sie einen gespeicherten Hash reproduzieren. Die Leitlinie der Federal Trade Commission (FTC) vom Juli 2024 trägt den Titel „Nein, Hashing macht Ihre Daten nicht anonym.“
Regulierungsbehörden betrachten maskierte Daten nicht automatisch als sicher
Nach den Pseudonymisierungsregeln der DSGVO bleiben pseudonymisierte Daten personenbezogen. Erwägungsgrund 26 der gleichen Verordnung umfasst alle Daten, die einer Person mit zusätzlichen Informationen zugeordnet werden können, und die Leitlinien 01/2025 des EDSB besagen, dass Pseudonymisierung stets weitere Maßnahmen erfordert.
Am 4. September 2025 entschied der Gerichtshof der Europäischen Union (EuGH) in EDPS gegen SRB (C-413/23 P) dass pseudonymisierte Daten für einen Empfänger, der die Personen nicht reidentifizieren kann, nicht als personenbezogene Daten gelten, die Pflichten des Verantwortlichen jedoch bestehen bleiben, einschließlich der Information der Betroffenen, wer ihre Daten erhält.
Nach HIPAA verlangt das Büro für Bürgerrechte des US-Gesundheitsministeriums (HHS OCR) entweder eine Expertenbestimmung oder Safe Harbor.
Wie Sie entscheiden, ob Maskierung für Ihre Daten ausreicht
Die eigentliche Entscheidung betrifft Typ, Technik, Daten und weitere Unterstützungen. Die folgenden Überlegungen behandeln Inventar, nachgelagerte Nutzung, regulatorische Pflichten und Zugangskontrollen, die bestimmen, ob ein Maskierungsansatz vertretbar ist.
Beginnen Sie damit, zu wissen, was Sie haben
Erstellen und pflegen Sie ein aktuelles Inventar darüber, wo sensible Daten gespeichert sind und welche Art sie haben, bevor Sie eine Maskierungsregel festlegen. Eine Maskierungsregel ist nur so gut wie das Inventar, das Ihnen die Zieltabellen nennt.
Der Netwrix 2026 Bericht zur Daten- und Identitätssicherheit ergab, dass 57 % der Organisationen ein solches Inventar nicht kontinuierlich führen, und NIST CSF 2.0 nennt es als Unterkategorie (ID.AM-07). Führen Sie automatisierte Erkennung und Klassifizierung für jede Datenbank, Freigabe und Cloud-Speicher durch und speisen Sie die Ergebnisse direkt in Ihre Maskierungskonfiguration ein.
Passen Sie die Technik an die Anforderungen der nachfolgenden Daten an
Verfolgen Sie jedes sensible Feld bis zu seinen nachgelagerten Nutzern und wählen Sie dann die Technik, die diese Nutzer funktionsfähig hält. Google Transformationsrichtlinien empfiehlt Schwärzung, Ersatz oder Maskierung, wenn der nachgelagerte Gebrauch den Originalwert oder stabile Verknüpfungen nicht benötigt, und kryptografische Tokenisierung, wenn doch. Für Analysen, bei denen Reihenfolge und Verteilung wichtig sind, wenden Sie stattdessen Datenbündelung oder Datumsverschiebung an. Entwicklungs- und Testkopien, die nur echt aussehen müssen, zielen auf Substitution; Zahlungsfelder, die ein Prozessor validieren muss, auf Tokenisierung oder FPE.
Prüfen Sie, was Ihr Rechtsrahmen verlangt
Ermitteln Sie, welcher Standard für den Datensatz gilt, bevor Sie eine Methode wählen, denn der Pseudonymisierungsstandard der DSGVO und die PCI-DSS-Speicheranforderungen setzen unterschiedliche Maßstäbe.
PCI DSS-Anforderung 3.5.1 erlaubt Einweg-Hashes des gesamten PAN basierend auf starker Kryptografie, Kürzung, Index-Token oder starker Kryptografie mit sicherer Geheimnisverwaltung. Es warnt, dass das Speichern von sowohl gekürzten als auch gehashten Versionen die Rekonstruktion des ursprünglichen PAN ermöglichen kann.
DSGVO verlangt separate Umkehrinformationen, wie Zuordnungstabellen und kryptografische Geheimnisse, die unter technischen und organisatorischen Kontrollen gehalten werden. HIPAA Safe Harbor hingegen ist eine Checkliste mit 18 Identifikatoren und erfordert kein Wissen darüber, ob das Verbleibende jemanden identifizieren könnte, daher wird nie ein Umkehrpfad verlangt.
Kombinieren Sie Maskierung mit Zugriffskontrolle
Überprüfen Sie, wer auf die Originaldaten zugreifen kann, und entziehen Sie nicht mehr gerechtfertigten Zugriff. Wiederholen Sie diese Überprüfung in festgelegten Abständen. Der Netwrix Data and Identity Security Report 2026 zeigt, dass 75 % der sensiblen Datenlecks mit kompromittierten Identitäten oder falsch konfigurierten Berechtigungen beginnen.
Deshalb reicht Maskierung allein nicht aus, um das Risiko zu beseitigen, da die Exposition an der Schnittstelle von sensiblen Daten und Identitäten, Rollen und Berechtigungen besteht, die darauf zugreifen können. Verknüpfen Sie diese Entdeckungsarbeit mit den Kontrollen, die darauf wirken, wie dynamische Maskierung, Verschlüsselung, Tokenisierung und Zugriffsverwaltung, sodass das Auffinden sensibler Daten nicht nur im Erstellen eines Inventars endet.
Wie Netwrix Ihnen hilft, Datenmaskierung richtig umzusetzen
Der Großteil der oben genannten Arbeit, vom Aufbau des Inventars bis zur Anpassung der Techniken an regulatorische Rahmenbedingungen, gilt unabhängig von den eingesetzten Werkzeugen. Netwrix bündelt die Entdeckung, den Zugriffskontext und die Compliance-Nachweise, die die meisten Maskierungsprogramme noch manuell zusammenstellen, in einer Plattform.
Wissen, was man maskieren muss, bevor man es macht
Netwrix DSPM findet und klassifiziert sensible Daten in hybriden Umgebungen, erkennt übermäßige oder offene Zugriffe und priorisiert Risiken zur Behebung.
Netwrix Access Analyzer unterstützt Netwrix DSPM, indem es sensible Daten entdeckt, klassifiziert und analysiert, wer auf über 40 unterstützte Datenquellen zugreifen kann.
Dieses Ergebnis sollte die oben genannten Maskierungsentscheidungen steuern, da es zeigt, welche Felder sensible Daten enthalten und welche Technik zur Nutzung jedes Feldes nach der Produktion passt.
Risiken jenseits des verdeckten Textes erkennen
Netwrix DSPM nutzt Klassifizierung als Eingabe und ergänzt den Zugriffskontext, den Maskierung nicht liefern kann. Die Klassifizierung sagt, was die Daten sind. DSPM sagt, wer darauf zugreifen kann und was zu beheben ist.
Netwrix DSPM erkennt veraltete Nutzerzugriffe, offene Zugriffe und risikoreiche Berechtigungen auf sensible Daten, sodass ein Maskierungsprogramm regelt, wer das Original sehen darf und was die Kopien offenbaren.
Erstellung von Nachweisen, die Prüfer akzeptieren
Netwrix Access Analyzer ordnet entdeckte und klassifizierte Daten Frameworks wie GDPR, HIPAA und PCI DSS zu. Es zeigt auch, wer Zugriff auf Daten hat, und unterstützt Zugriffsüberprüfungsprozesse, sodass Teams Nachweise zu Governance-Kontrollen beim Maskieren erhalten.
Netwrix Auditor bietet umfassendere vordefinierte Compliance-Berichte und Prüfpfade für Infrastruktur- und Datensysteme.
Mit Netwrix Auditor bereitet sich First National Bank and Trust of Beloit in nur einer Stunde auf Prüfungen des Office of the Comptroller of the Currency (OCC) vor, statt in einer Woche.
Setzen Sie Datenmaskierung in Ihrer Datenschutzstrategie ein
Maskierung verringert die Exposition in Testkopien, Analyseauszügen und Supportansichten, jedoch nur, wenn Typ und Technik zur weiteren Verwendung jedes Feldes passen.
Fast jede Organisation hat bereits eine Maskierungspflicht; der Unterschied zwischen einem funktionierenden Programm und einer Papierpolitik ist, ob diese Pflicht die Daten-Teams erreicht, die täglich aus der Produktion kopieren.
Beginnen Sie mit einem genauen Inventar, denn jede nachfolgende Entscheidung zu Typ, Technik und regulatorischen Vorgaben hängt davon ab, zu wissen, was die Daten sind und wo sie liegen, und überprüfen Sie dieses Inventar so oft, wie sich die zugrundeliegenden Schemata ändern.
Fordern Sie eine Demo an und sehen Sie, wie Netwrix Ihnen hilft, sensible Daten zu entdecken und zu klassifizieren, Zugriffe zu steuern und die Compliance-Nachweise für ein Maskierungsprogramm zu erstellen.
Häufig gestellte Fragen zum Datenmaskieren
Teilen auf
Erfahren Sie mehr
Über den Autor

Netwrix Team
Erfahren Sie mehr zu diesem Thema
Überwachung der Datenbankaktivität: Was zu beachten ist und wie man es macht
OpenAI und die Umwelt, die KI erbt
Beispiel für Risikoanalyse: Wie man Risiken bewertet
Das CIA-Dreieck und seine Anwendung in der realen Welt
Quantitative Risikoanalyse: Jährliche Verlust Erwartung