
Enmascaramiento de datos explicado: técnicas, usos y límites
Oct 20, 2026
El enmascaramiento de datos limita la exposición innecesaria cuando los equipos copian valores sensibles de producción en pruebas, análisis y flujos de trabajo compartidos. Sustituye esos valores por equivalentes realistas, pero implementaciones débiles aún permiten inferencias, enlaces o reversión. Los programas efectivos eligen técnicas según el uso posterior y prueban cada resultado contra su flujo previsto.
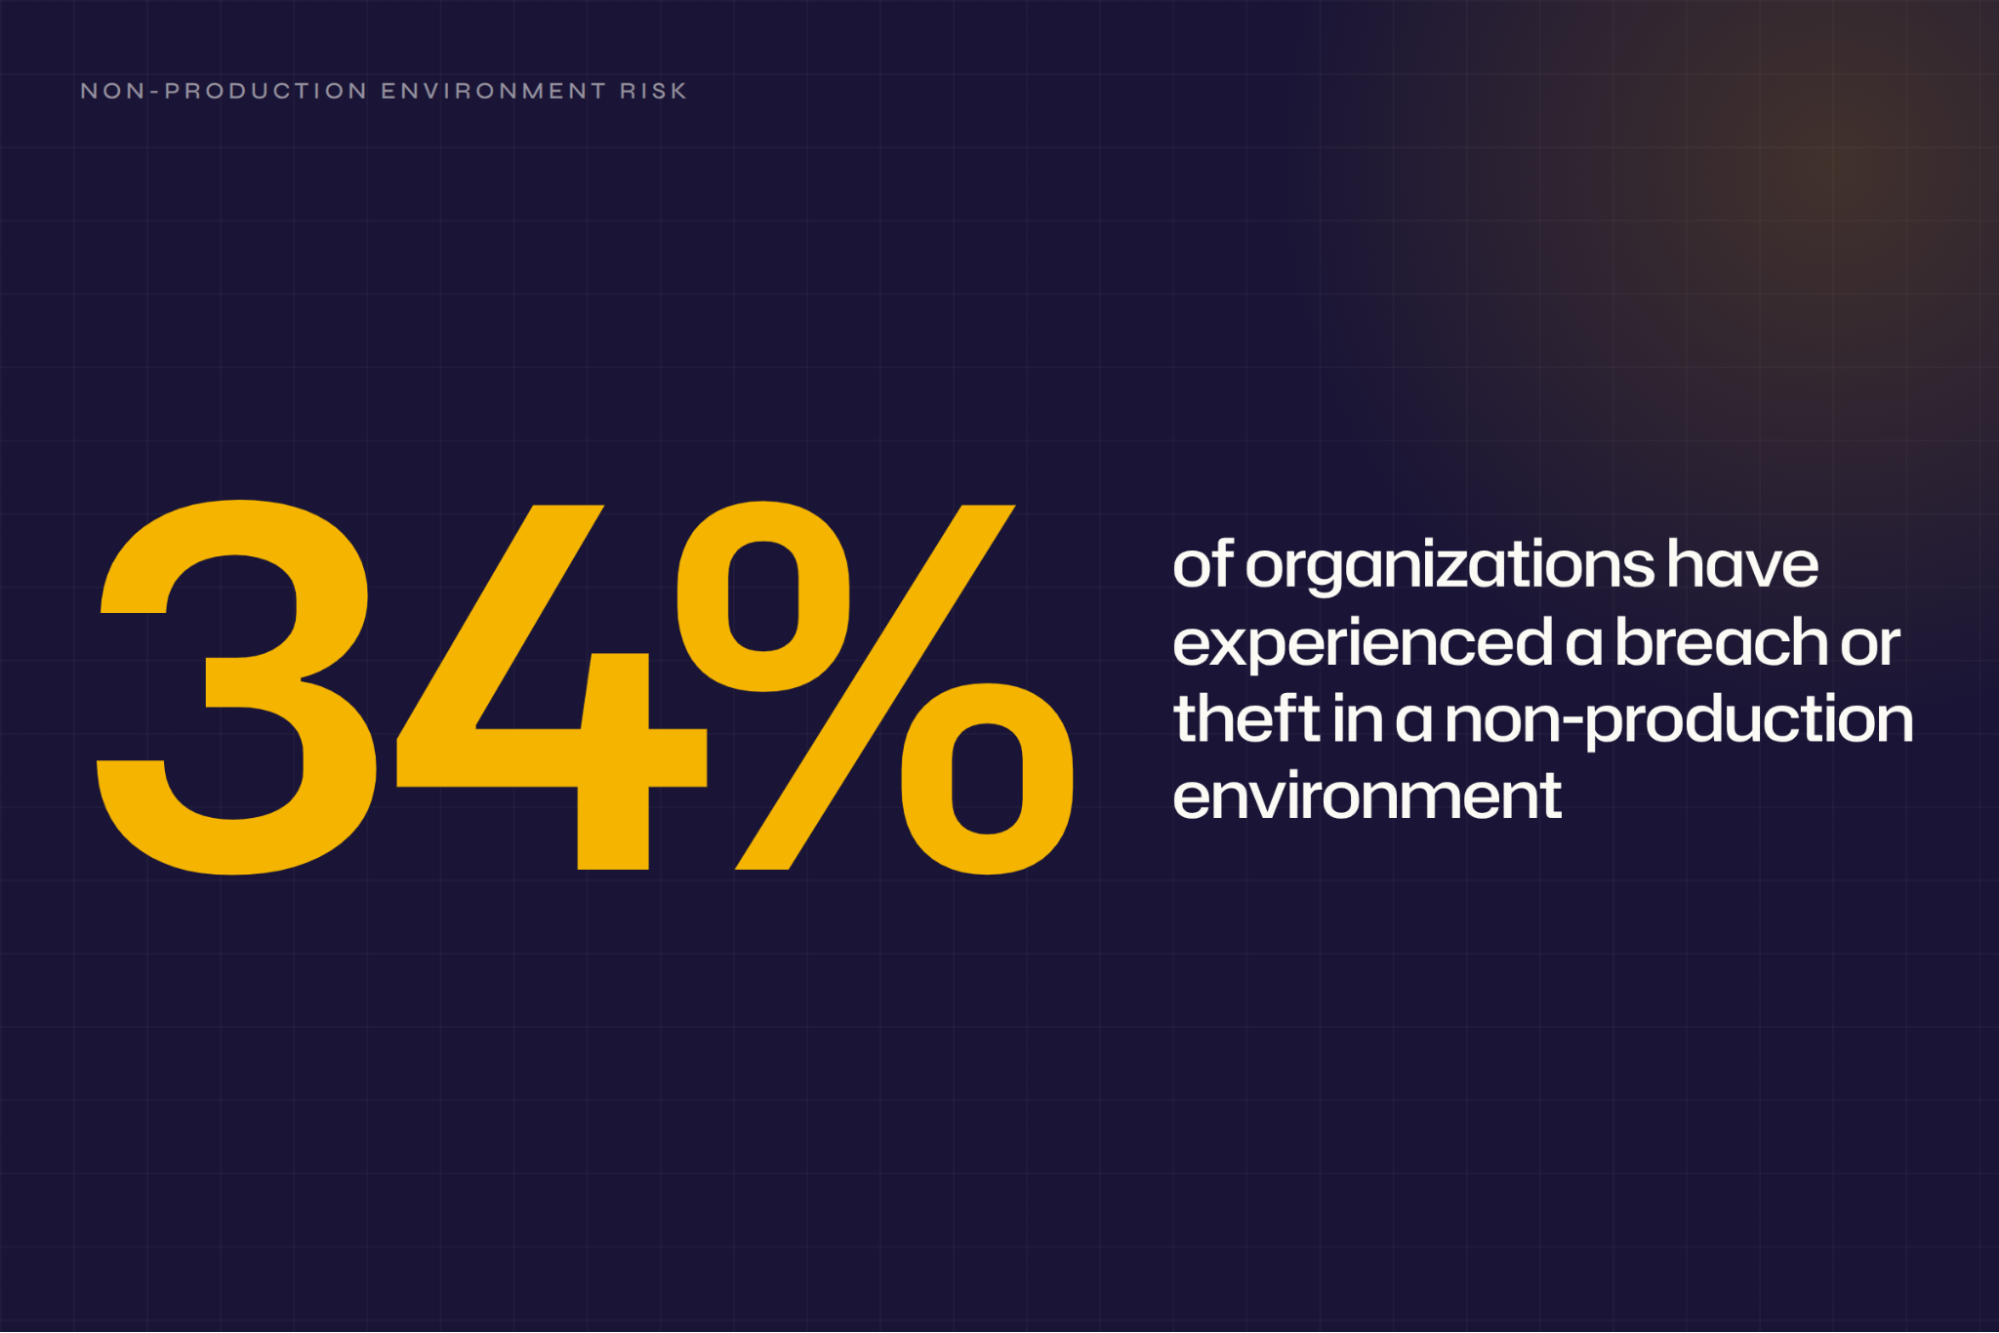
Un mandato de enmascaramiento de datos existe en el 99% de las organizaciones, pero el 84% aún permite excepciones y el 34% ha sufrido una brecha o robo en un entorno no productivo, según el Informe sobre el Estado de Cumplimiento y Seguridad de Datos 2026 de Perforce Delphix.
Esa brecha entre la política y la práctica debilita controles que serían sólidos, porque un requisito formal cumplido solo en papel no garantiza que la técnica elegida proteja los datos.
Los datos enmascarados aún pueden revelar información sensible a través del contexto. Un usuario con acceso a consultas puede inferir los valores subyacentes detrás de una máscara dinámica comparando resultados de diferentes consultas.
El enfoque correcto considera esas debilidades antes de que los equipos creen copias en entornos inferiores o expongan vistas de producción enmascaradas, y comienza con adaptar el tipo y la técnica de enmascaramiento a lo que debe hacer cada campo una vez que sale de producción.
¿Qué es el enmascaramiento de datos?
El enmascaramiento de datos es una técnica de protección que sustituye valores sensibles por sustitutos realistas y no sensibles para que los datos sigan siendo utilizables sin revelar los valores reales. Un campo enmascarado mantiene su formato y tipo de dato, por lo que un número de Seguro Social enmascarado aún pasa una validación de nueve dígitos y un salario enmascarado sigue comportándose como un número que un informe puede sumar.
Esa combinación, un sustituto que se parece y actúa como el original sin revelar cuál era, permite que los equipos de desarrollo, análisis y soporte trabajen con datos de calidad productiva sin la exposición que implica el original.
El enmascaramiento difiere de la encriptación de datos, que cualquiera con la clave de desencriptación puede revertir, y de la redacción de datos, que elimina el valor por completo y deja a los evaluadores sin un sustituto útil.
¿Por qué es importante el enmascaramiento de datos?
El enmascaramiento apoya varios objetivos operativos y de cumplimiento cuando los equipos lo aplican a los datos y entornos adecuados:
- Los entornos no productivos dejan de ser un riesgo: Los equipos de desarrollo, pruebas y aseguramiento de calidad (QA) obtienen datos reales mientras la producción la información personal identificable (PII) se mantiene fuera de los volcado de bases de datos.
- Los programas de cumplimiento obtienen pruebas a las que pueden referirse: El enmascaramiento se corresponde directamente con los controles de seudonimización y minimización de datos que los auditores ya reconocen en las principales normativas de protección de datos y pagos.
- La analítica y la IA avanzan más rápido: Los analistas y modelos aprenden de patrones reales mientras los registros identificables permanecen protegidos.
- Los entornos de menor confianza tienen un menor alcance de impacto: Si alguien accede al sistema de pruebas de un proveedor o al clúster de QA de una organización, los datos correctamente enmascarados no les ofrecen nada real que tomar.
- Los equipos de soporte solucionan problemas sin acceder a registros sin procesar: Un representante de help desk puede reproducir el problema del cliente usando una copia enmascarada en lugar de acceder a la cuenta real.
¿Cuáles son los tipos de enmascaramiento de datos?
El enmascaramiento de datos varía según cuándo y dónde se realice. Elegir el tipo correcto determina quién ve el valor sin enmascarar y cuántas copias enmascaradas quedan dispersas en el entorno.
Enmascaramiento estático de datos
El enmascaramiento estático es el predeterminado para todo lo que tu equipo entrega. Copias datos de producción, los enmascaras permanentemente y los envías a desarrollo, pruebas o control de calidad. El resultado es irreversible, ya que no puedes recuperar los valores originales de la copia y no hay ninguna clave de descifrado que requiera protección.
Microsoft presentó una vista previa del enmascaramiento estático de datos en SQL Server Management Studio (SSMS) 18 en 2018, pero lo retiró antes de su disponibilidad general (GA). Un empleado de Microsoft confirmó en una respuesta en la comunidad técnica de febrero de 2023 que no está en la hoja de ruta.
La técnica subyacente sigue siendo estándar en la mayoría de las cadenas de herramientas de extracción, transformación y carga (ETL) y migración de bases de datos, sin importar lo que soporte nativamente cada proveedor.
El problema más difícil es la integridad referencial, ya que enmascarar un ID de cliente en una tabla requiere asignar ese mismo valor sustituto a todas las demás tablas que se unan a ella, o las uniones fallarán sin aviso.
Enmascaramiento dinámico de datos
El enmascaramiento dinámico de datos (DDM) es compatible con entornos donde los equipos deben consultar directamente el conjunto de datos de producción en lugar de trabajar con una copia separada. Enmascara valores sensibles en los resultados de las consultas para usuarios no privilegiados, dejando los datos almacenados sin cambios.
Un representante de soporte que consulta producción ve XXXX donde está el número de Seguro Social (SSN), mientras que un administrador con privilegios elevados ve el valor real. Este método mantiene una copia de producción segura en lugar de una enmascarada separada, pero cualquiera con roles elevados en la base de datos, y quien pueda hacer una consulta lo suficientemente precisa, aún accede al valor original.
Una consulta como WHERE Salary > 99999 and Salary < 100001 confirma un salario enmascarado sin que la máscara se muestre, por lo que DDM es adecuado para exposiciones accidentales y no para atacantes decididos.
Impide que una consulta casual devuelva un valor que no debería, pero nada en este método detiene a quien intencionalmente estrecha su consulta hasta que la máscara revela la respuesta de todos modos.
Netwrix DSPM detecta y protege datos sensibles en entornos locales, híbridos y en la nube. Solicite una demostración.
Enmascaramiento instantáneo y determinista
El enmascaramiento en tiempo real, también llamado enmascaramiento en vuelo, se ejecuta dentro de un trabajo de migración o ETL (extraer, transformar y cargar) que lee desde la fuente y escribe solo valores enmascarados al destino, por lo que cada copia intermedia contiene valores protegidos. Estas canalizaciones requieren planificación de rendimiento para grandes volúmenes.
El enmascaramiento determinista asigna la misma entrada a la misma salida siempre, en tablas, bases de datos y trabajos, manteniendo las uniones y relaciones referenciales.
Técnicas de enmascaramiento de datos
Los equipos deben elegir solo las técnicas que requieren sus flujos de trabajo. Relaciona cada técnica con lo que hace el campo después de la producción.
Sustitución
La sustitución reemplaza un valor real por uno falso realista extraído de una tabla de búsqueda o diccionario. También puede funcionar de forma determinista, asignando al mismo ID de cliente el mismo valor falso cada vez que aparece, para que las uniones entre bases de datos de RRHH, nómina y beneficios sigan funcionando.
Esa tabla de consulta también es la debilidad. Si se filtra, expone todo el mapeo original a enmascarado, y la guía de OWASP considera almacenar secretos criptográficos o datos de mapeo junto con datos seudonimizados como un patrón inseguro.
Utilice sustitución en conjuntos de datos de desarrollo y QA cuando los evaluadores necesiten nombres, direcciones y números de cuenta que parezcan y funcionen como reales, ya que la validación de formato, la representación de la interfaz y las uniones entre tablas siguen funcionando.
Barajando
El barajado reorganiza los valores de la columna para que cada fila reciba el valor de otra fila. Oracle Data Safe señala que el barajado conserva la distribución general de datos de la columna, y la variante de barajado por grupo de Oracle mantiene los intercambios dentro de una categoría, como los salarios en una misma categoría laboral. Cada valor real permanece en el conjunto de datos pero en una fila diferente, por lo que los equipos deben decidir si eso ofrece suficiente protección.
Si identificadores cuasi-relacionados como el código postal, la fecha de nacimiento y el género no se mezclan o se mezclan por separado, alguien puede volver a vincular las filas. Mézclalos juntos y reserva esta técnica para conjuntos de datos analíticos donde importa más la distribución de una columna que qué registro tiene cada valor.
Redacción y anulación
La redacción elimina o borra un valor por completo. La máscara predeterminada de SQL Server, por ejemplo, convierte las cadenas en XXXX y los números en 0. Una máscara predeterminada es fácil de configurar, pero destruye la utilidad del campo para pruebas o análisis. Úsela solo en campos que no tengan propósito posterior en un entorno inferior, como un SSN completo, un número de tarjeta completo o una columna de notas de texto libre que nadie necesite ver.
Tokenización y cifrado que preserva el formato
La tokenización reemplaza un número de cuenta principal (PAN) con un token sustituto, mientras que el cifrado que preserva el formato (FPE) mantiene el formato y la longitud del texto cifrado. Ambos son reversibles por diseño, lo que cambia el modelo de riesgo. Los tokens basados en bóveda dependen de una búsqueda; los tokens sin bóveda se derivan criptográficamente del PAN, por lo que el sistema solo almacena un secreto criptográfico.
Quien posea el secreto criptográfico o la bóveda puede recuperar todos los valores protegidos, por lo que gestionar esos secretos y bóvedas determina el riesgo residual, y PCI SSC advierte que comprometer la bóveda de datos podría comprometer todo el sistema de tokenización.
Elija tokenización o FPE cuando los datos de pago y financieros deban mantener su formato original o ser reversibles para un flujo autorizado; segmentar un sistema solo de tokens del entorno de tokenización puede incluso moverlo fuera del alcance de PCI DSS de datos del titular de la tarjeta.
Adición de ruido y varianza
La adición de ruido suma o multiplica una cantidad aleatoria a un valor numérico para que el total se mantenga mientras las cifras individuales se difuminan. La variación numérica en Informatica, una empresa de Salesforce, funciona así.
Documentos de Informatica que una entrada de 66 con una varianza simétrica del 50% se sitúa entre 33 y 99. Use la adición de ruido en informes y entrenamiento de modelos cuando la tendencia o distribución importe más que un solo registro, como bandas salariales, cohortes de edad y montos de transacciones.
Donde el enmascaramiento de datos falla
El enmascaramiento reduce la exposición, pero no es una solución completa al riesgo de datos por sí solo. Cada limitación a continuación determina cuánto control adicional necesita un programa de enmascaramiento, desde lo que ocurre cuando alguien combina los datos enmascarados con otros hasta si los reguladores consideran seguro el resultado.
Riesgo de reidentificación al combinar conjuntos de datos
Cualquiera que tenga un segundo conjunto de datos puede revelar datos enmascarados al combinarlos. Combinaciones como código postal, género y fecha de nacimiento pueden identificar a personas si un atacante dispone de datos auxiliares adecuados.
Un preprint de arXiv de febrero de 2026, Desanonimización masiva en línea con LLMs, reportó hasta un 68 % de recuperación con un 90 % de precisión para la reidentificación basada en LLM de usuarios en línea seudónimos, frente a casi 0 % para el mejor método sin LLM.
El estudio abarcó perfiles en línea en lugar de tablas enmascaradas, pero el mecanismo es el mismo: atributos residuales comparados con datos externos.
No protege los datos originales en reposo
El enmascaramiento genera una copia segura o una vista segura. El sistema de producción que contiene los valores reales aún requiere sus propios controles de acceso, cifrado y visibilidad.
Algunas técnicas son tan fuertes como su eslabón más débil
Una tabla de búsqueda, una bóveda de tokens o un esquema de hash pueden exponer todos los mapeos a la vez. Conjuntos de entradas pequeñas o predecibles también permiten a los atacantes probar valores candidatos hasta reproducir un hash almacenado. La guía de la Comisión Federal de Comercio (FTC) de julio de 2024 se titula "No, el hashing aún no hace que tus datos sean anónimos."
Los reguladores no consideran los datos enmascarados como automáticamente seguros
Según las normas de seudonimización del RGPD, los datos seudonimizados siguen siendo datos personales. El considerando 26 del mismo reglamento abarca cualquier dato que alguien pueda atribuir a una persona usando información adicional, y las Directrices 01/2025 del EDPB indican que la seudonimización siempre requiere medidas adicionales.
El 4 de septiembre de 2025, el Tribunal de Justicia de la Unión Europea (TJUE) dictaminó en EDPS contra SRB (C-413/23 P) que los datos seudonimizados pueden no considerarse datos personales para un destinatario que no pueda reidentificar a las personas, pero las obligaciones del responsable siguen vigentes, incluyendo informar a los interesados quién recibe sus datos.
Bajo HIPAA, la Oficina de Derechos Civiles del Departamento de Salud y Servicios Humanos de EE. UU. (HHS OCR) requiere Determinación Experta o Puerto Seguro.
Cómo decidir si el enmascaramiento es suficiente para sus datos
La verdadera decisión abarca qué tipo, qué técnica, para qué datos y qué más lo respalda. Las consideraciones a continuación recorren el inventario, el uso posterior, las obligaciones regulatorias y los controles de acceso que determinan si un enfoque de enmascaramiento es justificable.
Comienza por saber lo que tienes
Cree y mantenga un inventario en tiempo real de dónde datos sensibles se encuentran y qué tipo son antes de configurar cualquier regla de enmascaramiento. Una regla de enmascaramiento solo es tan buena como el inventario que indicó a qué tablas aplicarla.
El Informe de Seguridad de Datos e Identidad Netwrix 2026 reveló que el 57 % de las organizaciones no mantiene ese inventario de forma continua, y NIST CSF 2.0 lo menciona como una subcategoría (ID.AM-07). Realice un descubrimiento y clasificación automatizados en cada base de datos, recurso compartido y almacenamiento en la nube, y luego envíe los resultados directamente a la configuración de enmascaramiento.
Adapta la técnica a las necesidades de los datos posteriores
Rastrea cada campo sensible hasta sus consumidores posteriores y luego elige la técnica que mantenga esos consumidores funcionando. Guía de transformación de Google recomienda la redacción, sustitución o enmascaramiento cuando el uso posterior no requiere el valor original ni uniones estables, y la tokenización criptográfica cuando sí. Para análisis donde la secuencia y distribución importan, aplica agrupación de datos o desplazamiento de fechas. Las copias de desarrollo y prueba que solo deben parecer reales apuntan a la sustitución; los campos de pago que un procesador debe validar apuntan a la tokenización o FPE.
Verifique lo que exige su marco regulatorio
Identifique qué norma se aplica al conjunto de datos antes de elegir una técnica, porque la norma de seudonimización del GDPR y los requisitos de almacenamiento PCI DSS establecen diferentes estándares.
El requisito PCI DSS 3.5.1 acepta hashes unidireccionales del PAN completo basados en criptografía fuerte, truncamiento, tokens de índice o criptografía fuerte con gestión segura de secretos. Advierte que almacenar versiones truncadas y hasheadas puede permitir reconstruir el PAN original.
GDPR requiere información de reversión separada, como tablas de mapeo y secretos criptográficos, bajo controles técnicos y organizativos. Por el contrario, HIPAA Safe Harbor es una lista de verificación de 18 identificadores y no requiere saber si lo que queda podría identificar a alguien, por lo que nunca pide una ruta de reversión.
Combine el enmascaramiento con la gobernanza de acceso
Revise quién puede acceder a los datos originales y revoque el acceso que ya no esté justificado, luego repita esta revisión con una frecuencia definida. El Informe de Seguridad de Datos e Identidad Netwrix 2026 encontró que el 75 % de las exposiciones de datos sensibles comienzan con identidades comprometidas o permisos mal configurados.
Por eso, solo enmascarar no elimina el riesgo, ya que la exposición ocurre en la intersección de lo sensible y las identidades, roles y privilegios que pueden acceder a ella. Vincula ese trabajo de descubrimiento con los controles que actúan sobre ello, como el enmascaramiento dinámico, cifrado, tokenización y gobernanza de acceso, por lo que encontrar datos sensibles no termina en crear un inventario.
Cómo Netwrix te ayuda a hacer el enmascaramiento de datos correctamente
La mayor parte del trabajo anterior, desde crear el inventario hasta adaptar técnicas a marcos regulatorios, se aplica independientemente de las herramientas que use un equipo. Netwrix integra el descubrimiento, el contexto de acceso y la evidencia de cumplimiento que la mayoría de los programas de enmascaramiento aún reúnen manualmente en una sola plataforma.
Saber qué enmascarar antes de hacerlo
Netwrix DSPM detecta y clasifica datos sensibles en entornos híbridos, identifica accesos excesivos o abiertos y prioriza riesgos que requieren corrección.
Netwrix Access Analyzer impulsa Netwrix DSPM, descubriendo y clasificando datos sensibles y analizando quién puede acceder a ellos en más de 40 fuentes de datos compatibles.
Esa salida debe guiar las decisiones de enmascaramiento anteriores, ya que indica qué campos contienen datos sensibles y qué técnica se adapta al uso de cada campo tras salir de producción.
Ver el riesgo más allá del texto enmascarado
Netwrix DSPM usa la clasificación como entrada y añade el contexto de acceso que el enmascaramiento no puede proporcionar. La clasificación indica qué son los datos. DSPM indica quién puede acceder a ellos y qué corregir.
Netwrix DSPM identifica accesos obsoletos, accesos abiertos y permisos de alto riesgo en datos sensibles, por lo que un programa de enmascaramiento gestiona quién puede acceder al original y qué revelan las copias.
Generando pruebas aceptadas por auditores
Netwrix Access Analyzer asigna los datos descubiertos y clasificados a marcos como GDPR, HIPAA y PCI DSS. También informa quién tiene acceso a los datos y apoya los flujos de revisión de acceso, proporcionando a los equipos evidencia de los controles de gobernanza sobre el enmascaramiento.
Netwrix Auditor ofrece informes de cumplimiento predefinidos más amplios y registros de auditoría en infraestructura y sistemas de datos.
Con Netwrix Auditor, First National Bank and Trust de Beloit se prepara para las auditorías de la Oficina del Contralor de la Moneda (OCC) en solo una hora, en lugar de una semana.
Incorpora el enmascaramiento de datos en tu estrategia de protección de datos
El enmascaramiento reduce la exposición en copias de prueba, extractos analíticos y vistas de soporte, pero solo cuando el tipo y la técnica se ajustan al uso posterior de cada campo.
Casi todas las organizaciones ya tienen un mandato de enmascaramiento; lo que diferencia un programa efectivo de una política en papel es si ese mandato llega a los equipos de datos que copian desde producción cada día.
Comience con un inventario preciso, ya que cada decisión posterior sobre tipo, técnica y regulación depende de saber qué son los datos y dónde se encuentran, y revise ese inventario cada vez que cambien los esquemas subyacentes.
Solicita una demo para ver cómo Netwrix puede ayudarte a descubrir y clasificar datos sensibles, gestionar accesos y generar la evidencia de cumplimiento necesaria para un programa de enmascaramiento.
Preguntas frecuentes sobre el enmascaramiento de datos
Compartir en
Aprende más
Acerca del autor

Netwrix Team
Aprende más sobre este tema
Monitoreo de la actividad de la base de datos: qué observar y cómo hacerlo
OpenAI y el entorno que hereda la IA
Ejemplo de Análisis de Riesgos: Cómo Evaluar los Riesgos
El Triángulo de la CIA y su Aplicación en el Mundo Real
Análisis Cuantitativo de Riesgo: Expectativa de Pérdida Anual