
Mascaramento de dados explicado: técnicas, usos e limites
Oct 20, 2026
A mascaramento de dados limita a exposição desnecessária quando equipes copiam valores sensíveis de produção para testes, análises e fluxos de compartilhamento. Substitui esses valores por equivalentes realistas, mas implementações fracas ainda permitem inferência, ligação ou reversão. Programas eficazes selecionam técnicas com base no uso posterior e testam cada saída conforme o fluxo pretendido.
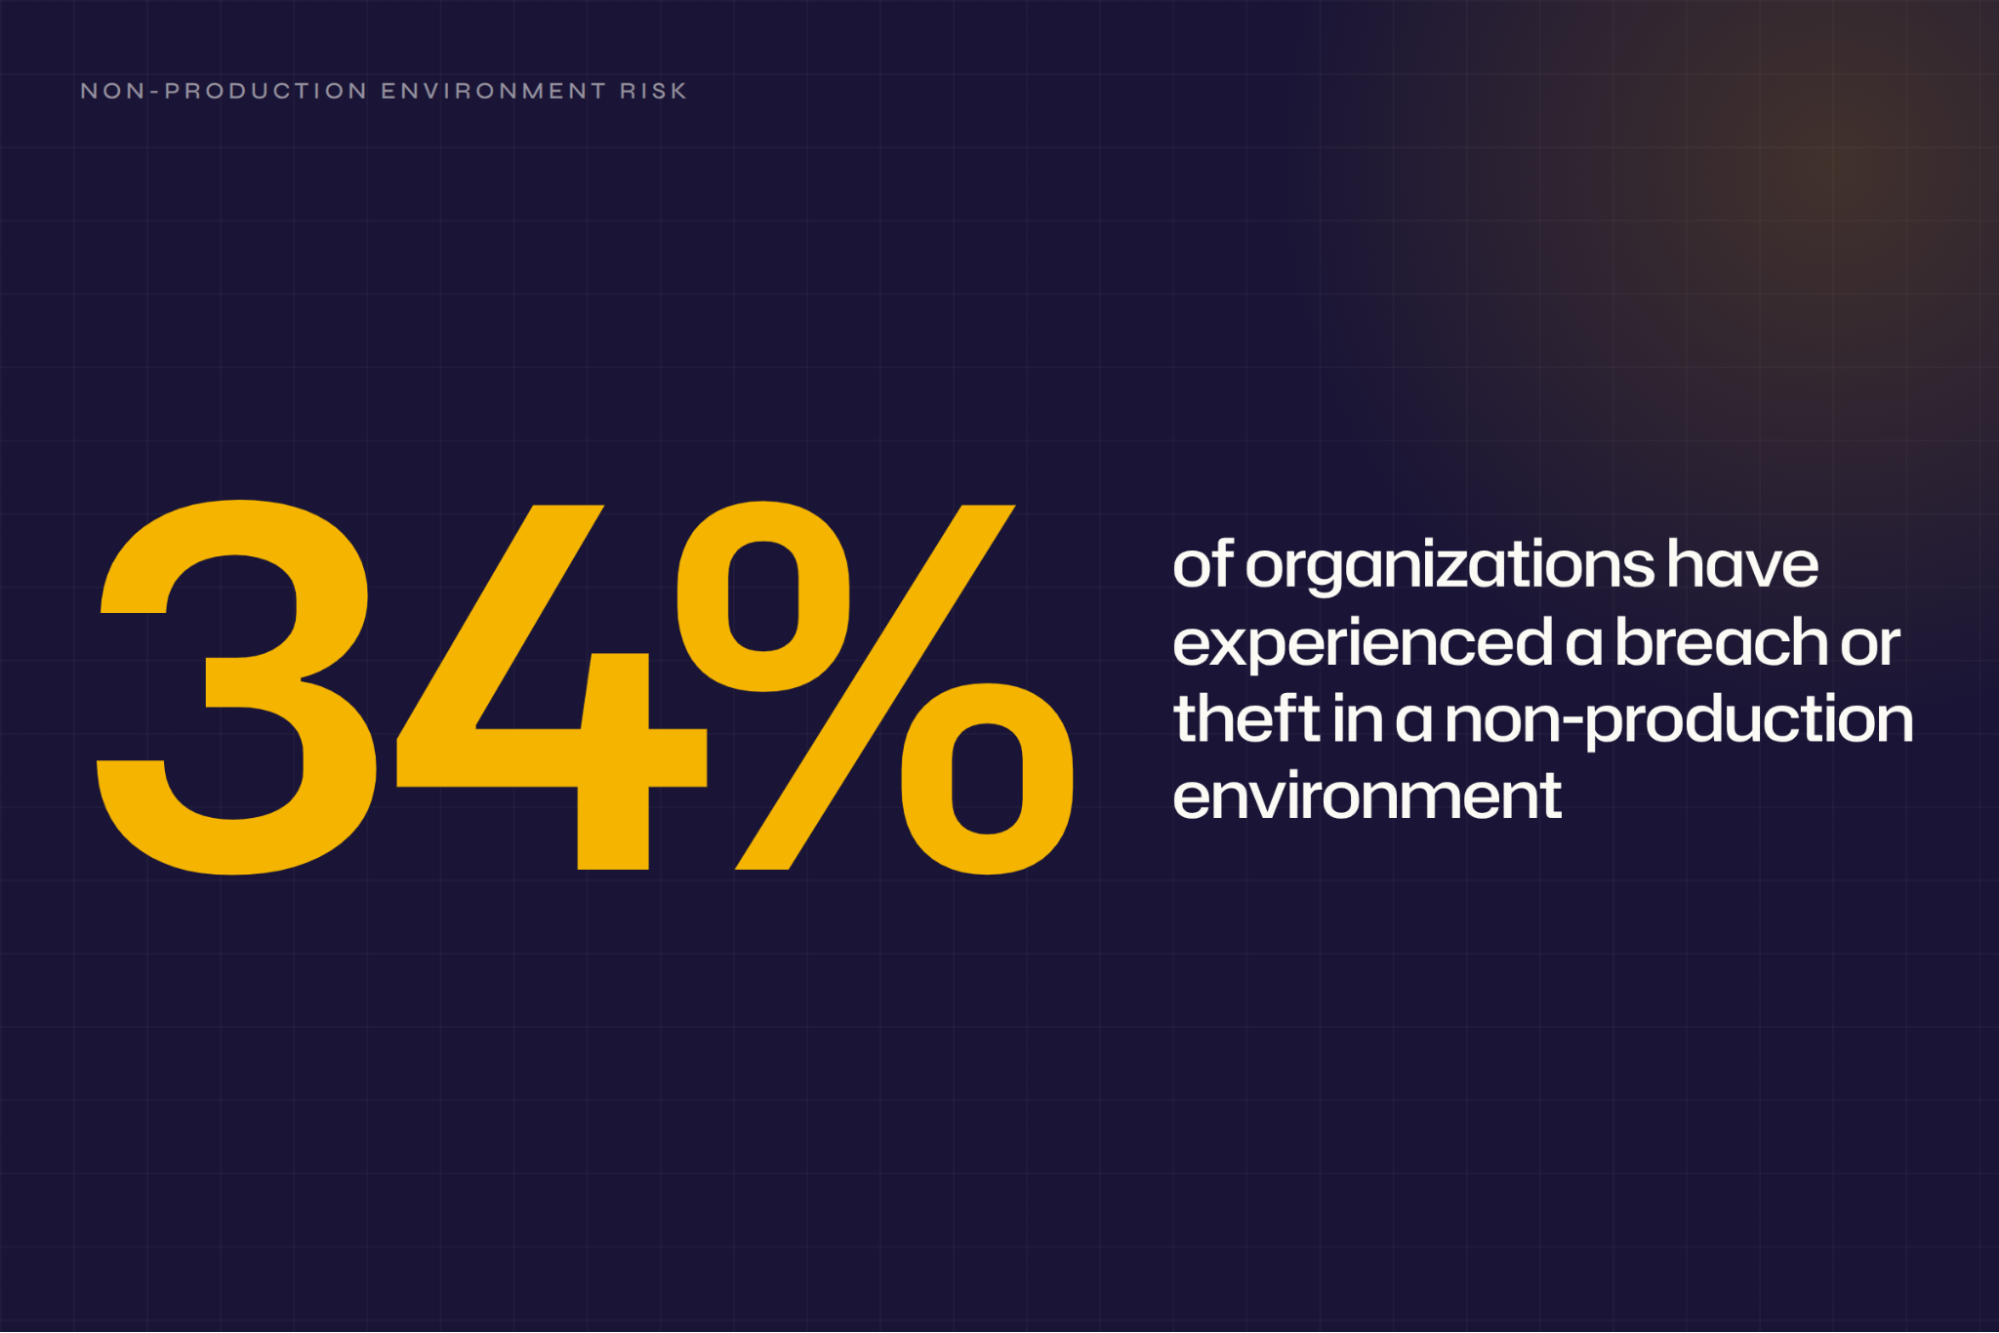
Um mandato de mascaramento de dados existe em 99% das organizações, mas 84% ainda permitem exceções e 34% já sofreram violação ou roubo em ambiente não produtivo, segundo o Relatório do Estado da Conformidade e Segurança de Dados 2026 da Perforce Delphix.
Essa distância entre política e prática enfraquece controles que seriam sólidos, pois uma exigência formal cumprida apenas no papel não garante que a técnica escolhida proteja os dados.
Dados mascarados ainda podem expor informações sensíveis pelo contexto ao redor. Um usuário com acesso a consultas pode inferir os valores subjacentes por trás de uma máscara dinâmica comparando resultados de diferentes consultas.
A abordagem correta considera essas fraquezas antes que as equipes criem cópias em ambientes inferiores ou exponham visualizações de produção mascaradas, começando por adequar o tipo e a técnica de mascaramento ao que cada campo deve fazer após sair da produção.
O que é mascaramento de dados?
A ocultação de dados é uma técnica de proteção que substitui valores sensíveis por substitutos realistas e não sensíveis para que os dados continuem utilizáveis sem expor os valores reais. Um campo oculto mantém seu formato e tipo de dado, assim um número de Segurança Social oculto ainda passa na validação de nove dígitos e um salário oculto ainda se comporta como um número que um relatório pode somar.
Essa combinação, um substituto que se parece e age como o original sem revelar qual era, permite que as equipes de desenvolvimento, análise e suporte trabalhem com dados de qualidade de produção sem a exposição dos dados reais.
A mascaramento difere da criptografia de dados, que qualquer pessoa com o segredo de descriptografia pode reverter, e da redação de dados, que apaga o valor completamente e deixa os testadores sem um substituto útil.
Por que a mascaramento de dados é importante?
A mascaramento apoia vários objetivos operacionais e de conformidade quando as equipes o aplicam aos dados e ambientes corretos:
- Ambientes não produtivos deixam de ser um problema: As equipes de desenvolvimento, teste e garantia de qualidade (QA) obtêm dados reais enquanto a produção informações pessoais identificáveis (PII) ficam fora dos dumps de banco de dados.
- Programas de conformidade obtêm evidências às quais podem se referir: A mascaramento corresponde diretamente aos controles de pseudonimização e minimização de dados que os auditores já reconhecem nas principais regulamentações de proteção de dados e pagamentos.
- Análise e IA avançam mais rápido: Analistas e modelos aprendem com padrões reais enquanto registros identificáveis permanecem protegidos.
- Ambientes de menor confiança têm menor raio de impacto: Se alguém obtiver acesso ao sistema de teste de um fornecedor ou ao cluster de QA de uma organização, dados devidamente mascarados não oferecem nada real para levar.
- As equipes de suporte resolvem problemas sem acessar registros brutos: Um atendente de help desk pode reproduzir o problema do cliente usando uma cópia mascarada, em vez da conta real.
Quais são os tipos de mascaramento de dados?
A mascaramento de dados varia conforme quando e onde ocorre. Escolher o tipo certo determina quem vê o valor sem máscara e quantas cópias mascaradas dos dados ficam espalhadas pelo ambiente.
Mascaramento estático de dados
A mascaramento estático é o padrão para tudo que sua equipe entrega. Você copia os dados da produção, os mascara permanentemente e os envia para desenvolvimento, teste ou QA. O resultado é irreversível, pois não é possível recuperar os valores originais da cópia e não há chave de descriptografia que precise de proteção.
A Microsoft apresentou uma prévia da mascaramento estático de dados no SQL Server Management Studio (SSMS) 18 em 2018, mas o removeu antes da disponibilidade geral (GA). Um funcionário da Microsoft confirmou em uma resposta na Tech Community de fevereiro de 2023 que não está no roteiro.
A técnica subjacente permanece padrão na maioria das ferramentas de extração, transformação e carga (ETL) e migração de banco de dados, independentemente do suporte nativo de cada fornecedor.
O problema mais difícil é a integridade referencial, pois mascarar um ID de cliente em uma tabela exige atribuir esse mesmo valor substituto a todas as outras tabelas que se juntam a ela, ou as junções falham silenciosamente.
Mascaramento dinâmico de dados
A mascaramento dinâmico de dados (DDM) suporta ambientes onde as equipes precisam consultar diretamente o conjunto de dados de produção, em vez de trabalhar com uma cópia separada. Ele mascara valores sensíveis nos resultados das consultas para usuários não privilegiados, mantendo os dados armazenados inalterados.
Um representante de suporte consultando a produção vê XXXX onde está o número de Seguro Social (SSN), enquanto um administrador com privilégios elevados vê o valor real. Essa abordagem mantém uma cópia de produção segura em vez de uma mascarada separada, mas qualquer pessoa com funções elevadas no banco de dados, e quem conseguir construir uma consulta suficientemente restrita, ainda acessa o valor original.
Uma consulta como WHERE Salary > 99999 and Salary < 100001 confirma um salário mascarado sem que a máscara apareça, por isso o DDM é adequado para exposições acidentais e não para atacantes determinados.
Impede que uma consulta casual retorne um valor que não deveria, mas nada impede quem restringe deliberadamente a consulta até que a máscara revele a resposta de qualquer forma.
Netwrix DSPM localiza e protege dados sensíveis em ambientes locais, híbridos e na nuvem. Solicite uma demonstração.
Mascaramento instantâneo e determinístico
A mascaramento em tempo real, também chamado de mascaramento em voo, é executado dentro de um trabalho de migração ou ETL (extrair, transformar e carregar) que lê da fonte e grava apenas valores mascarados no destino, de modo que cada cópia intermediária contenha valores protegidos. Esses pipelines exigem planejamento de capacidade para grandes volumes.
A mascaramento determinístico mapeia a mesma entrada para a mesma saída sempre, em tabelas, bancos de dados e tarefas, mantendo junções e relações referenciais.
Técnicas de mascaramento de dados
As equipes devem escolher apenas as técnicas que seus fluxos de trabalho exigem. Relacione cada técnica ao que o campo faz após a produção.
Substituição
A substituição troca um valor real por um falso realista retirado de uma tabela de consulta ou dicionário. A substituição também pode ser determinística, atribuindo o mesmo valor falso ao mesmo ID de cliente sempre que aparecer, para que as junções entre bancos de dados de RH, folha de pagamento e benefícios continuem funcionando.
Essa tabela de consulta é também a fraqueza. Se vazar, expõe todo o mapeamento original para mascarado, e a orientação da OWASP considera armazenar segredos criptográficos ou dados de mapeamento junto com dados pseudonimizados como um padrão inseguro.
Use substituição em conjuntos de dados de desenvolvimento e QA quando os testadores precisarem de nomes, endereços e números de conta que pareçam e se comportem como reais, pois a validação de formato, a renderização da interface e as junções entre tabelas continuam funcionando.
Embaralhando
A mistura reorganiza os valores da coluna para que cada linha receba o valor de outra linha. O Oracle Data Safe observa que a mistura preserva a distribuição geral dos dados da coluna, e a variante group shuffle da Oracle mantém as trocas dentro de uma categoria, como salários dentro de uma mesma categoria profissional. Cada valor real permanece no conjunto de dados, mas em uma linha diferente, então as equipes devem decidir se isso oferece proteção suficiente.
Se identificadores quase relacionados, como código postal, data de nascimento e gênero, não forem embaralhados ou forem embaralhados separadamente, alguém pode re-ligar as linhas. Embaralhe-os juntos e reserve a técnica para conjuntos de dados analíticos onde a distribuição de uma coluna importa mais que qual registro contém cada valor.
Redação e anulação
A redação remove ou apaga totalmente um valor. A máscara padrão do SQL Server, por exemplo, transforma strings em XXXX e números em 0. Uma máscara padrão é fácil de configurar, mas destrói a utilidade do campo para testes ou análises. Reserve-a para campos que não tenham uso posterior em um ambiente inferior, como um SSN completo, um número completo de cartão ou uma coluna de notas em texto livre que ninguém precise ver.
Tokenização e criptografia que preserva o formato
A tokenização substitui um número de conta primário (PAN) por um token substituto, enquanto a criptografia que preserva o formato (FPE) mantém o formato e o comprimento do texto cifrado. Ambos são reversíveis por design, o que altera o modelo de risco. Tokens baseados em cofre dependem de uma consulta; tokens sem cofre derivam criptograficamente do PAN, então o sistema armazena apenas um segredo criptográfico.
Quem detiver o segredo criptográfico ou o cofre pode recuperar todos os valores protegidos, portanto, gerenciar esses segredos e cofres determina o risco residual, e o PCI SSC alerta que comprometer o cofre de dados pode comprometer todo o sistema de tokenização.
Escolha tokenização ou FPE quando dados de pagamento e financeiros precisarem manter o formato original ou permanecer reversíveis para um fluxo autorizado; segmentar um sistema apenas de tokens do ambiente de tokenização pode até movê-lo para fora do escopo PCI DSS dos dados do titular do cartão.
Adição de ruído e variância
A adição de ruído soma ou multiplica uma quantidade aleatória a um valor numérico para que o total seja mantido enquanto os números individuais se confundem. A variação numérica na Informatica, uma empresa Salesforce, funciona assim.
Documentos Informatica indicando que uma entrada de 66 com uma variância simétrica de 50% fica entre 33 e 99. Use adição de ruído em relatórios e treinamento de modelos quando a tendência ou distribuição for mais importante que um único registro, como faixas salariais, coortes etárias e valores de transações.
Onde a mascaramento de dados falha
A mascaramento reduz a exposição, mas não é uma resposta completa ao risco de dados por si só. Cada limitação abaixo determina quanto controle adicional um programa de mascaramento ainda precisa, desde o que acontece quando alguém junta os dados mascarados com outra coisa até se os reguladores consideram o resultado seguro.
Risco de reidentificação ao combinar conjuntos de dados
Quem possuir um segundo conjunto de dados pode revelar dados mascarados ao cruzá-los. Combinações como CEP, gênero e data de nascimento podem identificar indivíduos quando um invasor tem dados auxiliares adequados.
Um preprint do arXiv de fevereiro de 2026, Desanonimização online em larga escala com LLMs, relatou até 68% de recall com 90% de precisão para reidentificação baseada em LLM de usuários online pseudônimos, contra quase 0% para o melhor método sem LLM.
O estudo abrangeu perfis online em vez de tabelas mascaradas, mas o mecanismo é o mesmo: atributos remanescentes comparados com dados externos.
Não protege os dados originais em repouso
A mascaramento gera uma cópia segura ou uma visualização segura. O sistema de produção que contém os valores reais ainda precisa de seus próprios controles de acesso, criptografia e visibilidade.
Algumas técnicas são tão fortes quanto seu elo mais fraco
Uma tabela de consulta, cofre de tokens ou esquema de hashing pode expor todos os mapeamentos de uma vez. Conjuntos de entrada pequenos ou previsíveis também permitem que atacantes testem valores candidatos até reproduzirem um hash armazenado. A orientação da Federal Trade Commission (FTC) de julho de 2024 é intitulada "Não, o hashing ainda não torna seus dados anônimos."
Os reguladores não consideram dados mascarados automaticamente seguros
De acordo com as regras de pseudonimização do RGPD, os dados pseudonimizados continuam sendo dados pessoais. O considerando 26 do mesmo regulamento abrange quaisquer dados que possam ser atribuídos a uma pessoa usando informações adicionais, e as Diretrizes 01/2025 do EDPB afirmam que a pseudonimização sempre requer medidas adicionais.
Em 4 de setembro de 2025, o Tribunal de Justiça da União Europeia (TJUE) decidiu em EDPS vs SRB (C-413/23 P) que dados pseudonimizados podem não ser considerados dados pessoais para um destinatário que não consiga reidentificar os indivíduos, mas as obrigações do controlador permanecem, incluindo informar os titulares sobre quem recebe seus dados.
De acordo com HIPAA, o Escritório de Direitos Civis do Departamento de Saúde e Serviços Humanos dos EUA (HHS OCR) exige Determinação de Especialista ou Safe Harbor.
Como decidir se a mascaramento é suficiente para seus dados
A verdadeira decisão envolve qual tipo, qual técnica, para quais dados e o que mais a suporta. As considerações abaixo analisam o inventário, o uso a jusante, as obrigações regulatórias e os controles de acesso que determinam se uma abordagem de mascaramento é defensável.
Comece sabendo o que você tem
Crie e mantenha um inventário atualizado de onde dados sensíveis estão e qual o tipo antes de configurar qualquer regra de mascaramento. Uma regra de mascaramento só é eficaz se o inventário indicar as tabelas corretas.
O Relatório de Segurança de Dados e Identidade Netwrix 2026 constatou que 57% das organizações não mantêm esse inventário continuamente, e NIST CSF 2.0 o nomeia como uma subcategoria (ID.AM-07). Execute a descoberta e classificação automatizadas em cada banco de dados, compartilhamento de arquivos e armazenamento em nuvem, e envie os resultados diretamente para sua configuração de mascaramento.
Combine a técnica com o que os dados precisam a jusante
Rastreie cada campo sensível até seus consumidores posteriores e escolha a técnica que mantém esses consumidores funcionando. Orientação de transformação do Google recomenda redação, substituição ou mascaramento quando o uso posterior não precisa do valor original ou junções estáveis, e tokenização criptográfica quando precisa. Para análises em que sequência e distribuição importam, aplique agrupamento de dados ou deslocamento de datas. Cópias de desenvolvimento e teste que só precisam parecer reais indicam substituição; campos de pagamento que um processador deve validar indicam tokenização ou FPE.
Confira o que seu marco regulatório exige
Identifique qual norma se aplica ao conjunto de dados antes de escolher uma técnica, pois o padrão de pseudonimização do GDPR e os requisitos de armazenamento PCI DSS definem critérios diferentes.
O requisito PCI DSS 3.5.1 aceita hashes unidirecionais do PAN completo baseados em criptografia forte, truncamento, tokens de índice ou criptografia forte com gerenciamento seguro de segredos. Alerta que armazenar versões truncadas e hasheadas pode permitir a reconstrução do PAN original.
GDPR exige informações separadas de reversão, como tabelas de mapeamento e segredos criptográficos, mantidos sob controles técnicos e organizacionais. Por outro lado, o HIPAA Safe Harbor é uma lista de verificação de 18 identificadores e não requer conhecimento de que o que resta poderia identificar alguém, portanto, nunca solicita um caminho de reversão.
Combine mascaramento com governança de acesso
Revise quem pode acessar os dados originais e revogue acessos que não são mais justificados, depois repita essa revisão em uma frequência definida. O Relatório Netwrix 2026 sobre Segurança de Dados e Identidade constatou que 75% das exposições de dados sensíveis começam com identidades comprometidas ou permissões mal configuradas.
Por isso, apenas mascarar não elimina o risco, pois a exposição ocorre na interseção do que é sensível e das identidades, funções e privilégios que podem acessá-lo. Conecte esse trabalho de descoberta aos controles que atuam sobre ele, como mascaramento dinâmico, criptografia, tokenização e governança de acesso, assim, encontrar dados sensíveis não termina em criar um inventário.
Como a Netwrix ajuda você a fazer a mascaramento de dados corretamente
A maior parte do trabalho acima, desde a criação do inventário até a adaptação das técnicas aos quadros regulatórios, aplica-se independentemente das ferramentas usadas pela equipe. A Netwrix reúne a descoberta, o contexto de acesso e as evidências de conformidade que a maioria dos programas de mascaramento ainda monta manualmente em uma única plataforma.
Saber o que mascarar antes de mascarar
Netwrix DSPM localiza e classifica dados sensíveis em ambientes híbridos, identifica acessos excessivos ou abertos e prioriza riscos que precisam ser corrigidos.
Netwrix Access Analyzer alimenta o Netwrix DSPM, descobrindo e classificando dados sensíveis e analisando quem pode acessá-los em mais de 40 fontes de dados suportadas.
Essa saída deve orientar as decisões de mascaramento acima, pois indica quais campos contêm dados sensíveis e qual técnica se encaixa no uso de cada campo após sair da produção.
Ver o risco além do texto mascarado
Netwrix DSPM usa a classificação como entrada e adiciona o contexto de acesso que a mascaramento não pode fornecer. A classificação mostra o que são os dados. O DSPM mostra quem pode acessá-los e o que corrigir.
O Netwrix DSPM identifica acessos obsoletos, acessos abertos e permissões de alto risco em dados sensíveis, para que um programa de mascaramento controle quem pode acessar o original e o que as cópias expõem.
Produzindo evidências aceitas por auditores
O Netwrix Access Analyzer mapeia dados descobertos e classificados para frameworks como GDPR, HIPAA e PCI DSS. Também informa quem tem acesso aos dados e apoia fluxos de revisão de acesso, fornecendo às equipes evidências dos controles de governança sobre mascaramento.
Netwrix Auditor oferece relatórios de conformidade predefinidos mais amplos e trilhas de auditoria em infraestrutura e sistemas de dados.
Com o Netwrix Auditor, First National Bank and Trust de Beloit se prepara para auditorias do Office of the Comptroller of the Currency (OCC) em apenas uma hora, em vez de uma semana.
Use mascaramento de dados na sua estratégia de proteção de dados
A mascaramento reduz a exposição em cópias de teste, extratos analíticos e visualizações de suporte, mas apenas quando o tipo e a técnica se ajustam ao uso posterior de cada campo.
Quase todas as organizações já têm um mandato de mascaramento; o que diferencia um programa eficaz de uma política no papel é se esse mandato alcança as equipes de dados que copiam da produção todos os dias.
Comece com um inventário preciso, pois toda decisão subsequente sobre tipo, técnica e regulamentação depende de saber o que são os dados e onde estão, e revise esse inventário sempre que os esquemas subjacentes mudarem.
Solicite uma demonstração para ver como a Netwrix pode ajudar a descobrir e classificar dados sensíveis, gerenciar acessos e produzir as evidências de conformidade que um programa de mascaramento exige.
Perguntas frequentes sobre mascaramento de dados
Compartilhar em
Saiba Mais
Sobre o autor
