
Masquage des données expliqué : techniques, cas d'utilisation et limites
Oct 20, 2026
Le masquage des données limite l’exposition inutile lorsque les équipes copient des valeurs sensibles de production dans les tests, l’analyse et les flux de partage. Il remplace ces valeurs par des substituts réalistes, mais des implémentations faibles permettent encore inférence, liaison ou inversion. Les programmes efficaces choisissent les techniques selon l’usage en aval et testent chaque sortie par rapport au flux prévu.
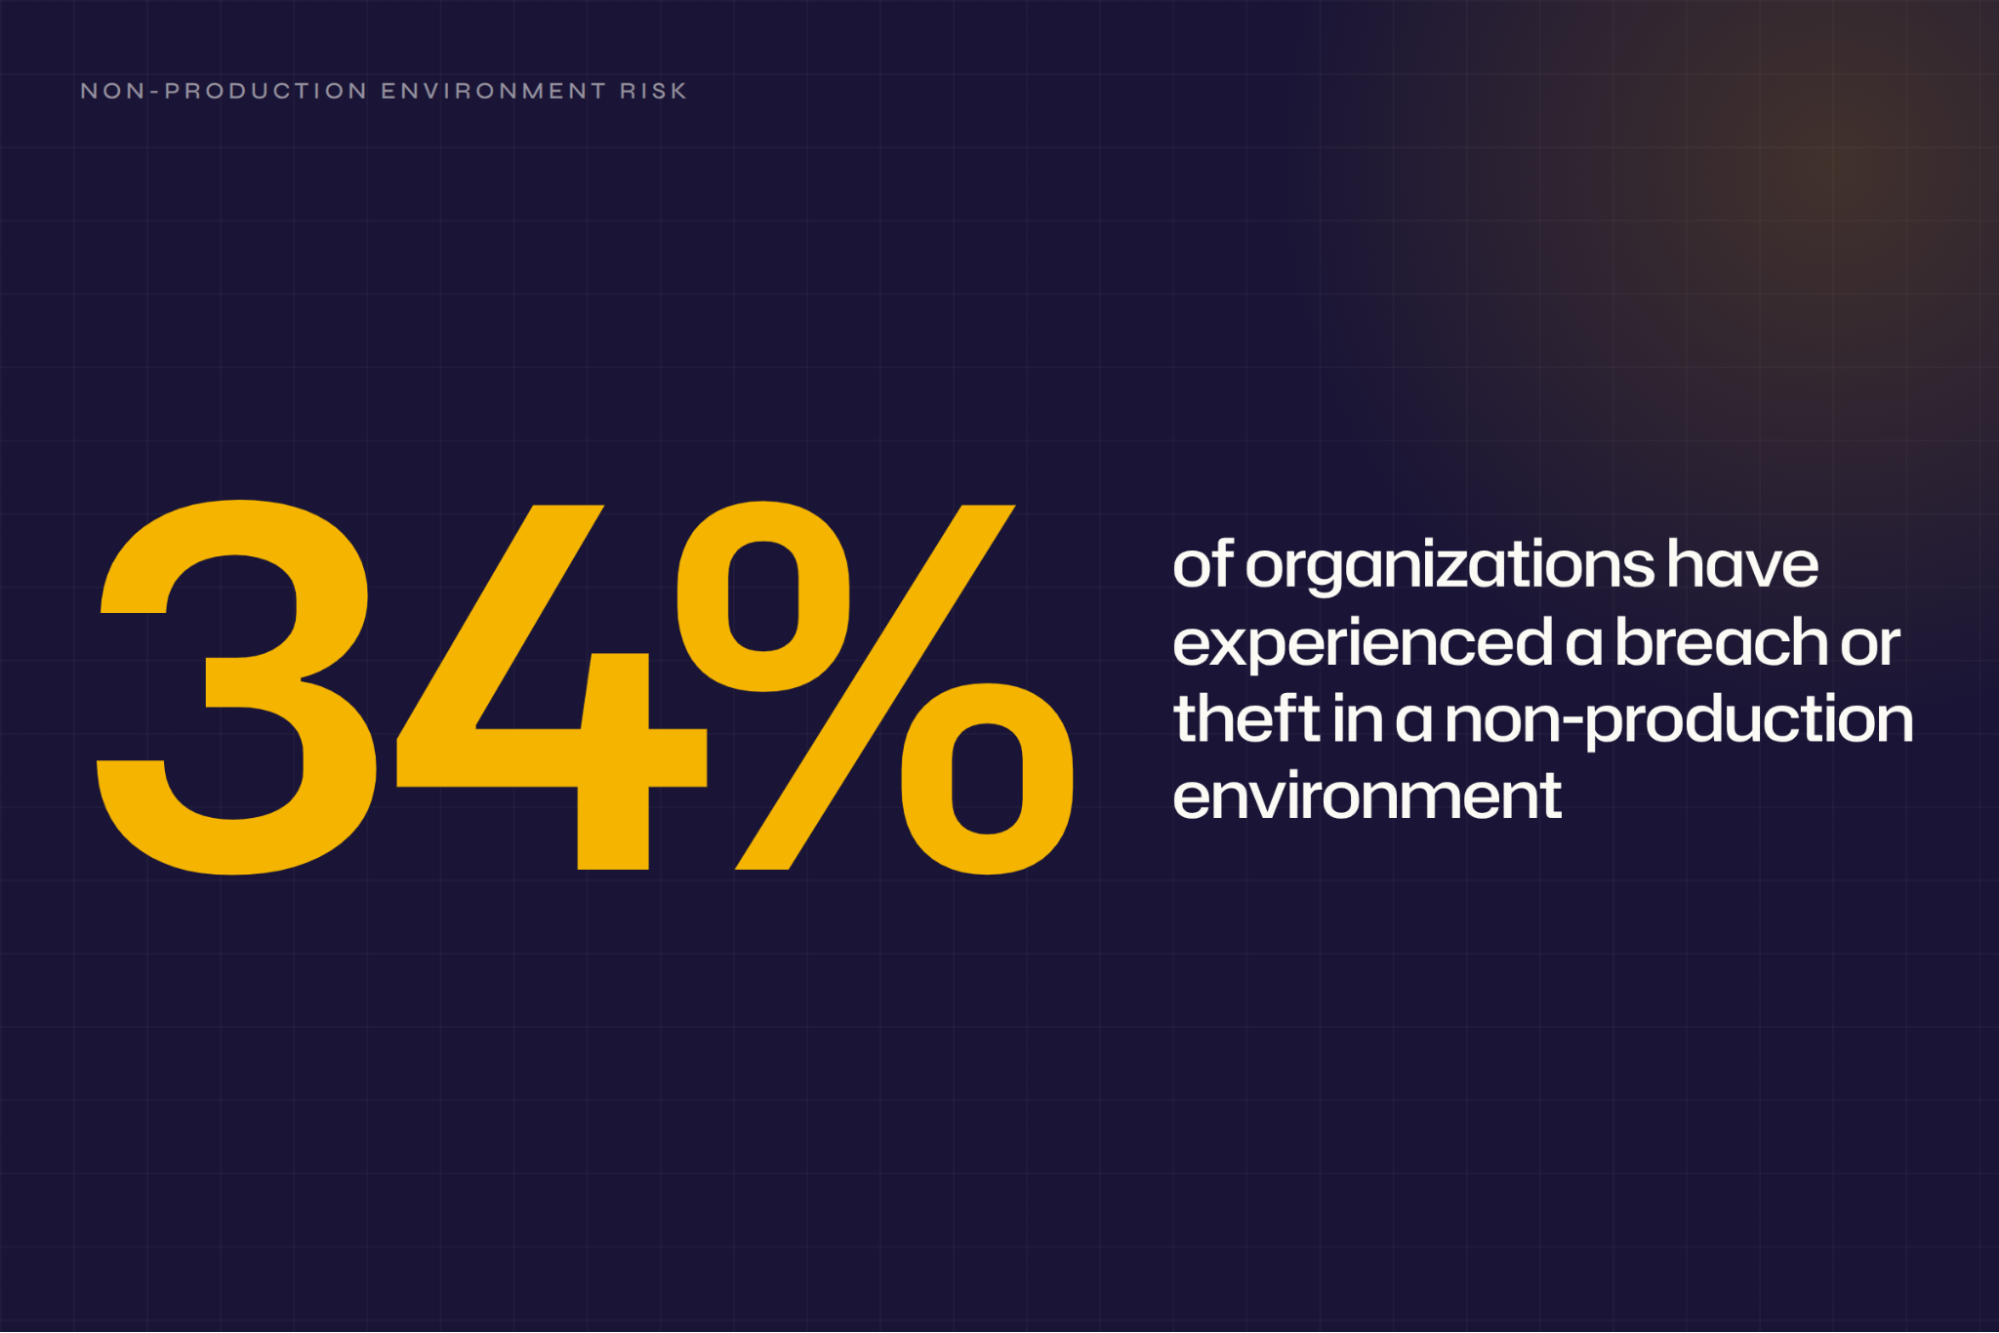
Un mandat de masquage des données existe dans 99 % des organisations, pourtant 84 % autorisent encore des exceptions et 34 % ont subi une violation ou un vol dans un environnement non productif, selon le Rapport sur l’État de la Conformité et de la Sécurité des Données 2026 de Perforce Delphix.
Cet écart entre la politique et la pratique affaiblit des contrôles autrement solides, car une exigence formelle satisfaite sur le papier ne garantit pas que la technique choisie protège les données.
Les données masquées peuvent toujours révéler des informations sensibles via le contexte environnant. Un utilisateur avec accès aux requêtes peut déduire les valeurs sous-jacentes derrière un masque dynamique en comparant les résultats de différentes requêtes.
La bonne approche prend en compte ces faiblesses avant que les équipes ne créent des copies en environnements inférieurs ou n'exposent des vues de production masquées, en commençant par adapter le type et la technique de masquage à ce que chaque champ doit faire une fois hors production.
Qu'est-ce que le masquage des données ?
Le masquage des données est une technique de protection qui remplace les valeurs sensibles par des substituts réalistes et non sensibles afin que les données restent utilisables sans exposer les valeurs réelles. Un champ masqué conserve son format et son type de données, ainsi un numéro de sécurité sociale masqué passe toujours une validation à neuf chiffres et un salaire masqué se comporte comme un nombre qu’un rapport peut additionner.
Cette combinaison, un substitut qui ressemble et se comporte comme l’original sans révéler ce qu’il était, permet aux équipes de développement, d’analyse et de support de travailler avec des données de qualité production sans l’exposition liée aux données réelles.
Le masquage diffère du chiffrement des données, que toute personne détenant le secret de déchiffrement peut inverser, et de la rédaction des données, qui supprime la valeur complètement et laisse les testeurs sans substitut utilisable.
Pourquoi le masquage des données est-il important ?
Le masquage soutient plusieurs objectifs opérationnels et de conformité lorsque les équipes l’appliquent aux bonnes données et environnements :
- Les environnements hors production ne sont plus un risque : Les équipes de développement, de test et d’assurance qualité (QA) obtiennent des données réalistes tandis que la production les informations personnelles identifiables (PII) restent exclues des dumps de base de données.
- Les programmes de conformité obtiennent des preuves auxquelles ils peuvent se référer : Le masquage correspond directement aux contrôles de pseudonymisation et de minimisation des données déjà reconnus par les auditeurs dans les principales réglementations sur la protection des données et les paiements.
- L'analyse et l'IA avancent plus vite : Les analystes et modèles apprennent à partir de schémas réalistes tandis que les données identifiables restent protégées.
- Les environnements à moindre confiance ont un rayon d’impact plus faible : Si quelqu’un accède au système de test d’un fournisseur ou au cluster QA d’une organisation, les données correctement masquées ne lui donnent rien de réel à prendre.
- Les équipes support résolvent les problèmes sans toucher aux données brutes : Un agent du support peut reproduire le problème d’un client sur une copie masquée au lieu d’accéder au compte réel.
Quels sont les types de masquage des données ?
Le masquage des données prend une forme différente selon le moment et le lieu où il se produit. Choisir le bon type détermine qui voit la valeur non masquée et combien de copies masquées des données se retrouvent dispersées dans l’environnement.
Masquage statique des données
Le masquage statique est la méthode par défaut pour tout ce que votre équipe transmet. Vous copiez les données de production, les masquez définitivement, puis les envoyez en développement, test ou QA. Le résultat est irréversible, car il est impossible de récupérer les valeurs originales à partir de la copie, et aucune clé de déchiffrement n’est stockée nécessitant une protection.
Microsoft a présenté une préversion du masquage statique des données dans SQL Server Management Studio (SSMS) 18 en 2018, puis l’a retiré avant la disponibilité générale (GA). Un employé de Microsoft a confirmé dans une réponse sur la Tech Community de février 2023 que ce n’est pas au programme.
La technique sous-jacente reste standard dans la plupart des chaînes d'outils d'extraction, transformation et chargement (ETL) et de migration de bases de données, quel que soit le support natif de chaque fournisseur.
Le problème le plus difficile est l'intégrité référentielle, car masquer un ID client dans une table nécessite d'assigner cette même valeur de substitution à toutes les autres tables qui s'y joignent, sinon les jointures échouent silencieusement.
Masquage dynamique des données
Le masquage dynamique des données (DDM) prend en charge les environnements où les équipes doivent interroger directement le jeu de données de production au lieu de travailler à partir d'une copie séparée. Il masque les valeurs sensibles dans les résultats des requêtes pour les utilisateurs non privilégiés tout en laissant les données stockées inchangées.
Un représentant support interrogeant la production voit XXXX là où se trouve le numéro de sécurité sociale (SSN), tandis qu’un administrateur avec des privilèges élevés voit la valeur réelle. Cette méthode conserve une copie de production sécurisée au lieu d’une copie masquée séparée, mais toute personne avec des rôles élevés en base de données, et qui peut construire une requête assez précise, accède toujours à la valeur originale.
Une requête comme WHERE Salary > 99999 and Salary < 100001 confirme un salaire masqué sans que le masque ne soit jamais visible, c’est pourquoi le DDM convient aux expositions accidentelles plutôt qu’aux attaquants déterminés.
Cela empêche une requête occasionnelle de renvoyer une valeur non souhaitée, mais rien dans cette méthode n'empêche quelqu'un de restreindre délibérément sa requête jusqu'à ce que le masque révèle la réponse.
Netwrix DSPM détecte et protège les données sensibles dans les environnements sur site, hybrides et cloud. Demandez une démo.
Masquage instantané et déterministe
Le masquage à la volée, aussi appelé masquage en cours de traitement, s’exécute dans un travail de migration ou ETL (extraction, transformation et chargement) qui lit la source et écrit uniquement des valeurs masquées vers la cible, de sorte que chaque copie intermédiaire contient des valeurs protégées. Ces pipelines nécessitent une planification du débit pour les gros volumes.
Le masquage déterministe associe toujours la même entrée à la même sortie, dans les tables, bases de données et tâches, assurant le fonctionnement des jointures et relations référentielles.
Techniques de masquage des données
Les équipes doivent choisir uniquement les techniques requises par leurs flux de travail. Associez chaque technique à ce que fait le champ après la production.
Substitution
La substitution remplace une valeur réelle par une fausse valeur réaliste tirée d’une table de correspondance ou d’un dictionnaire. Elle peut aussi s’exécuter de manière déterministe, attribuant la même fausse valeur au même ID client à chaque apparition, afin que les jointures entre bases RH, paie et avantages fonctionnent toujours.
Cette table de correspondance est aussi la faiblesse. En cas de fuite, elle révèle toute la correspondance original-masqué, et les recommandations OWASP considèrent le stockage de secrets cryptographiques ou de données de correspondance avec des données pseudonymisées comme un schéma non sécurisé.
Utilisez la substitution dans les jeux de données de développement et QA lorsque les testeurs ont besoin de noms, adresses et numéros de compte qui ressemblent et se comportent comme des vrais, car la validation du format, le rendu de l’interface et les jointures entre tables fonctionnent toujours.
Mélange
Le mélange réarrange les valeurs des colonnes pour que chaque ligne reçoive la valeur d'une autre ligne. Oracle Data Safe note que le mélange préserve la distribution globale des données de la colonne, et la variante group shuffle d'Oracle maintient les échanges à l'intérieur d'une catégorie, comme les salaires dans une même catégorie professionnelle. Chaque valeur réelle reste dans le jeu de données mais sur une ligne différente, donc les équipes doivent décider si cela offre une protection suffisante.
Si des quasi-identifiants liés comme le code postal, la date de naissance et le sexe ne sont pas mélangés ou le sont séparément, quelqu’un peut relier les lignes. Mélangez-les ensemble et réservez cette technique aux jeux de données analytiques où la distribution d’une colonne compte plus que le record qui détient chaque valeur.
Rédaction et annulation
La rédaction supprime ou efface complètement une valeur. Le masque par défaut de SQL Server, par exemple, transforme les chaînes en XXXX et les nombres en 0. Un masque par défaut est facile à configurer, mais il détruit l’utilité du champ pour les tests ou l’analyse. Réservez-le aux champs sans usage en aval dans un environnement inférieur, comme un numéro de sécurité sociale complet, un numéro de carte complet ou une colonne de notes en texte libre que personne n’a besoin de voir.
Tokenisation et chiffrement préservant le format
La tokenisation remplace un numéro de compte principal (PAN) par un jeton de substitution, tandis que le chiffrement préservant le format (FPE) préserve le format et la longueur du texte chiffré. Les deux sont réversibles par conception, ce qui modifie le modèle de risque. Les jetons basés sur un coffre reposent sur une recherche ; les jetons sans coffre sont dérivés cryptographiquement du PAN, donc le système ne stocke qu'un secret cryptographique.
Quiconque détient le secret cryptographique ou le coffre peut récupérer toutes les valeurs protégées, donc la gestion de ces secrets et coffres détermine le risque résiduel, et le PCI SSC avertit que compromettre le coffre de données pourrait compromettre tout le système de tokenisation.
Choisissez la tokenisation ou FPE lorsque les données de paiement et financières doivent conserver leur format d'origine ou rester réversibles pour un flux autorisé ; segmenter un système uniquement à jetons de l'environnement de tokenisation peut même le déplacer hors du périmètre PCI DSS des données du titulaire de la carte.
Ajout de bruit et variance
L'ajout de bruit ajoute ou multiplie une quantité aléatoire à une valeur numérique pour que l'agrégat soit conservé tandis que les chiffres individuels deviennent flous. La variance numérique chez Informatica, une société Salesforce, fonctionne ainsi.
Documents Informatica indiquant qu'une entrée de 66 avec une variance symétrique de 50 % se situe entre 33 et 99. Utilisez l'ajout de bruit dans les rapports et l'entraînement des modèles lorsque la tendance ou la distribution importe plus qu'un seul enregistrement, comme les tranches salariales, les cohortes d'âge et les montants des transactions.
Là où le masquage des données échoue
Le masquage réduit l’exposition, mais ce n’est pas une réponse complète au risque des données à lui seul. Chaque limitation ci-dessous détermine le contrôle supplémentaire nécessaire pour un programme de masquage, depuis ce qui se passe quand quelqu’un croise les données masquées avec d’autres jusqu’à si les régulateurs jugent le résultat sûr.
Risque de réidentification lors de la combinaison des ensembles de données
Toute personne disposant d’un second jeu de données peut démasquer des données masquées en les croisant. Des combinaisons comme le code postal, le sexe et la date de naissance peuvent identifier des individus si un attaquant possède des données auxiliaires appropriées.
Un preprint arXiv de février 2026, Dé-anonymisation en ligne à grande échelle avec des LLM, a rapporté jusqu'à 68 % de rappel à 90 % de précision pour la ré-identification basée sur LLM d'utilisateurs en ligne pseudonymes, contre près de 0 % pour la meilleure méthode sans LLM.
L'étude portait sur des profils en ligne plutôt que sur des tableaux masqués, mais le mécanisme est le même : des attributs restants comparés à des données externes.
Il ne protège pas les données originales au repos
Le masquage produit une copie ou une vue sécurisée. Le système de production contenant les vraies valeurs nécessite toujours ses propres contrôles d'accès, chiffrement et visibilité.
Certaines techniques ne sont fortes que jusqu’à leur maillon le plus faible
Une table de correspondance, un coffre à jetons ou un schéma de hachage peuvent révéler toutes les correspondances en même temps. Des ensembles d’entrées petits ou prévisibles permettent aussi aux attaquants de tester des valeurs candidates jusqu’à reproduire un hachage stocké. La directive de la Federal Trade Commission (FTC) de juillet 2024 s’intitule « Non, le hachage ne rend toujours pas vos données anonymes. »
Les régulateurs ne considèrent pas les données masquées comme automatiquement sûres
Selon les règles de pseudonymisation du RGPD, les données pseudonymisées restent des données personnelles. Le considérant 26 du même règlement couvre toute donnée pouvant être attribuée à une personne via des informations supplémentaires, et les Lignes directrices 01/2025 du CEPD indiquent que la pseudonymisation nécessite toujours des mesures complémentaires.
Le 4 septembre 2025, la Cour de justice de l'Union européenne (CJUE) a statué dans EDPS c. SRB (C-413/23 P) que les données pseudonymisées peuvent ne pas être considérées comme des données personnelles pour un destinataire incapable de réidentifier les individus, mais les obligations du responsable restent, notamment informer les personnes concernées de qui reçoit leurs données.
Selon HIPAA, le Bureau des droits civils du Département américain de la santé et des services sociaux (HHS OCR) exige soit une Détermination d'Expert, soit un Safe Harbor.
Comment décider si le masquage suffit pour vos données
La vraie décision porte sur le type, la technique, les données concernées et ce qui la soutient. Les considérations ci-dessous passent en revue l’inventaire, l’utilisation en aval, les obligations réglementaires et les contrôles d’accès qui déterminent si une approche de masquage est défendable.
Commencez par savoir ce que vous avez
Créez et maintenez un inventaire en temps réel de l'endroit où les données sensibles se trouvent et de leur type avant de configurer toute règle de masquage. Une règle de masquage n'est efficace que si l'inventaire indique les tables concernées.
Le Rapport Netwrix 2026 sur la Sécurité des Données et de l'Identité a révélé que 57 % des organisations ne tiennent pas un inventaire continu, et NIST CSF 2.0 le désigne comme une sous-catégorie (ID.AM-07). Lancez une découverte et une classification automatisées sur chaque base de données, partage de fichiers et stockage cloud, puis intégrez les résultats directement dans votre configuration de masquage.
Adaptez la technique aux besoins des données en aval
Suivez chaque champ sensible jusqu’à ses consommateurs en aval, puis choisissez la technique qui maintient ces consommateurs en fonctionnement. Guide de transformation Google recommande la rédaction, le remplacement ou le masquage lorsque l’usage en aval ne nécessite pas la valeur originale ni des jointures stables, et la tokenisation cryptographique lorsqu’il le faut. Pour les analyses où la séquence et la distribution comptent, appliquez plutôt le regroupement des données ou le décalage des dates. Les copies de développement et test qui doivent seulement paraître réelles privilégient la substitution ; les champs de paiement qu’un processeur doit valider privilégient la tokenisation ou FPE.
Vérifiez ce que votre cadre réglementaire exige
Identifiez la norme applicable au jeu de données avant de choisir une technique, car la norme de pseudonymisation du RGPD et les exigences de stockage PCI DSS fixent des seuils différents.
L'exigence PCI DSS 3.5.1 accepte les hachages unidirectionnels du PAN complet basés sur une cryptographie forte, la troncature, les jetons d'index ou une cryptographie forte avec gestion sécurisée des secrets. Elle avertit que stocker à la fois les versions tronquées et hachées peut permettre de reconstituer le PAN original.
RGPD exige des informations de réversion séparées, telles que des tables de correspondance et des secrets cryptographiques, sous contrôles techniques et organisationnels. En revanche, HIPAA Safe Harbor est une liste de contrôle de 18 identifiants et ne nécessite pas de savoir si ce qui reste pourrait identifier quelqu’un, donc elle ne demande jamais de chemin de réversion.
Associez le masquage à la gouvernance des accès
Vérifiez qui peut accéder aux données originales et révoquez les accès non justifiés, puis répétez cette vérification à intervalles réguliers. Le rapport Netwrix 2026 sur la sécurité des données et des identités a révélé que 75 % des expositions de données sensibles commencent par des identités compromises ou des permissions mal configurées.
C’est pourquoi le masquage seul ne suffit pas à éliminer le risque, car l’exposition se situe à l’intersection de ce qui est sensible et des identités, rôles et privilèges qui peuvent y accéder. Reliez ce travail de découverte aux contrôles qui l’appliquent, comme le masquage dynamique, le chiffrement, la tokenisation et la gouvernance des accès, ainsi, trouver des données sensibles ne s’arrête pas à la création d’un inventaire.
Comment Netwrix vous aide à réussir le masquage des données
La plupart des tâches ci-dessus, de la création de l'inventaire à l'adaptation des techniques aux cadres réglementaires, s'appliquent quel que soit l'outil utilisé par une équipe. Netwrix regroupe la découverte, le contexte d'accès et les preuves de conformité que la plupart des programmes de masquage assemblent encore manuellement en une seule plateforme.
Savoir quoi masquer avant de le faire
Netwrix DSPM détecte et classe les données sensibles dans les environnements hybrides, identifie les accès excessifs ou ouverts et priorise les risques à corriger.
Netwrix Access Analyzer alimente Netwrix DSPM, découvrant et classifiant les données sensibles et analysant qui peut y accéder parmi plus de 40 sources de données prises en charge.
Cette sortie doit orienter les décisions de masquage ci-dessus, car elle indique quels champs contiennent des données sensibles et quelle technique convient à l’usage de chaque champ après la production.
Voir le risque au-delà du texte masqué
Netwrix DSPM prend la classification en entrée et ajoute le contexte d'accès que le masquage ne peut fournir. La classification indique ce que sont les données. DSPM indique qui peut y accéder et ce qu'il faut corriger.
Netwrix DSPM identifie les accès obsolètes, ouverts et à haut risque aux données sensibles, permettant à un programme de masquage de gérer qui peut accéder à l’original et ce que révèlent les copies.
Fournir des preuves acceptées par les auditeurs
Netwrix Access Analyzer associe les données découvertes et classifiées aux cadres tels que GDPR, HIPAA et PCI DSS. Il indique également qui a accès aux données et prend en charge les workflows de revue d'accès, fournissant aux équipes des preuves des contrôles de gouvernance liés au masquage.
Netwrix Auditor fournit des rapports de conformité prédéfinis plus étendus et des pistes d’audit sur les infrastructures et systèmes de données.
Avec Netwrix Auditor, First National Bank and Trust de Beloit se prépare aux audits de l'Office du Contrôleur de la Monnaie (OCC) en seulement une heure, au lieu d'une semaine.
Intégrez le masquage des données dans votre stratégie de protection des données
Le masquage réduit l’exposition dans les copies de test, les extractions analytiques et les vues de support, mais seulement lorsque le type et la technique correspondent à l’utilisation en aval de chaque champ.
Presque toutes les organisations ont déjà un mandat de masquage ; ce qui distingue un programme opérationnel d’une politique sur papier est que ce mandat atteigne les équipes de données qui copient depuis la production chaque jour.
Commencez par un inventaire précis, car chaque décision ultérieure sur le type, la technique et la réglementation dépend de la connaissance des données et de leur emplacement, et revisitez cet inventaire aussi souvent que les schémas sous-jacents changent.
Demandez une démo pour voir comment Netwrix peut vous aider à découvrir et classer les données sensibles, gérer les accès et produire les preuves de conformité indispensables à un programme de masquage.
Questions fréquentes sur le masquage des données
Partager sur
En savoir plus
À propos de l'auteur

Netwrix Team
En savoir plus sur ce sujet
Surveillance de l'activité de la base de données : quoi surveiller et comment le faire
OpenAI et l'environnement que l'IA hérite
Exemple d'analyse des risques : Comment évaluer les risques
Le Triangle CIA et son application dans le monde réel
Analyse quantitative des risques : Espérance de perte annuelle