
Mascheramento dei dati spiegato: tecniche, casi d'uso e limiti
Oct 20, 2026
La mascheratura dei dati limita l’esposizione non necessaria quando i team copiano valori sensibili di produzione in test, analisi e flussi di condivisione. Sostituisce quei valori con equivalenti realistici, ma implementazioni deboli permettono ancora inferenze, collegamenti o inversioni. Programmi efficaci scelgono tecniche basate sull’uso a valle e testano ogni output rispetto al flusso previsto.
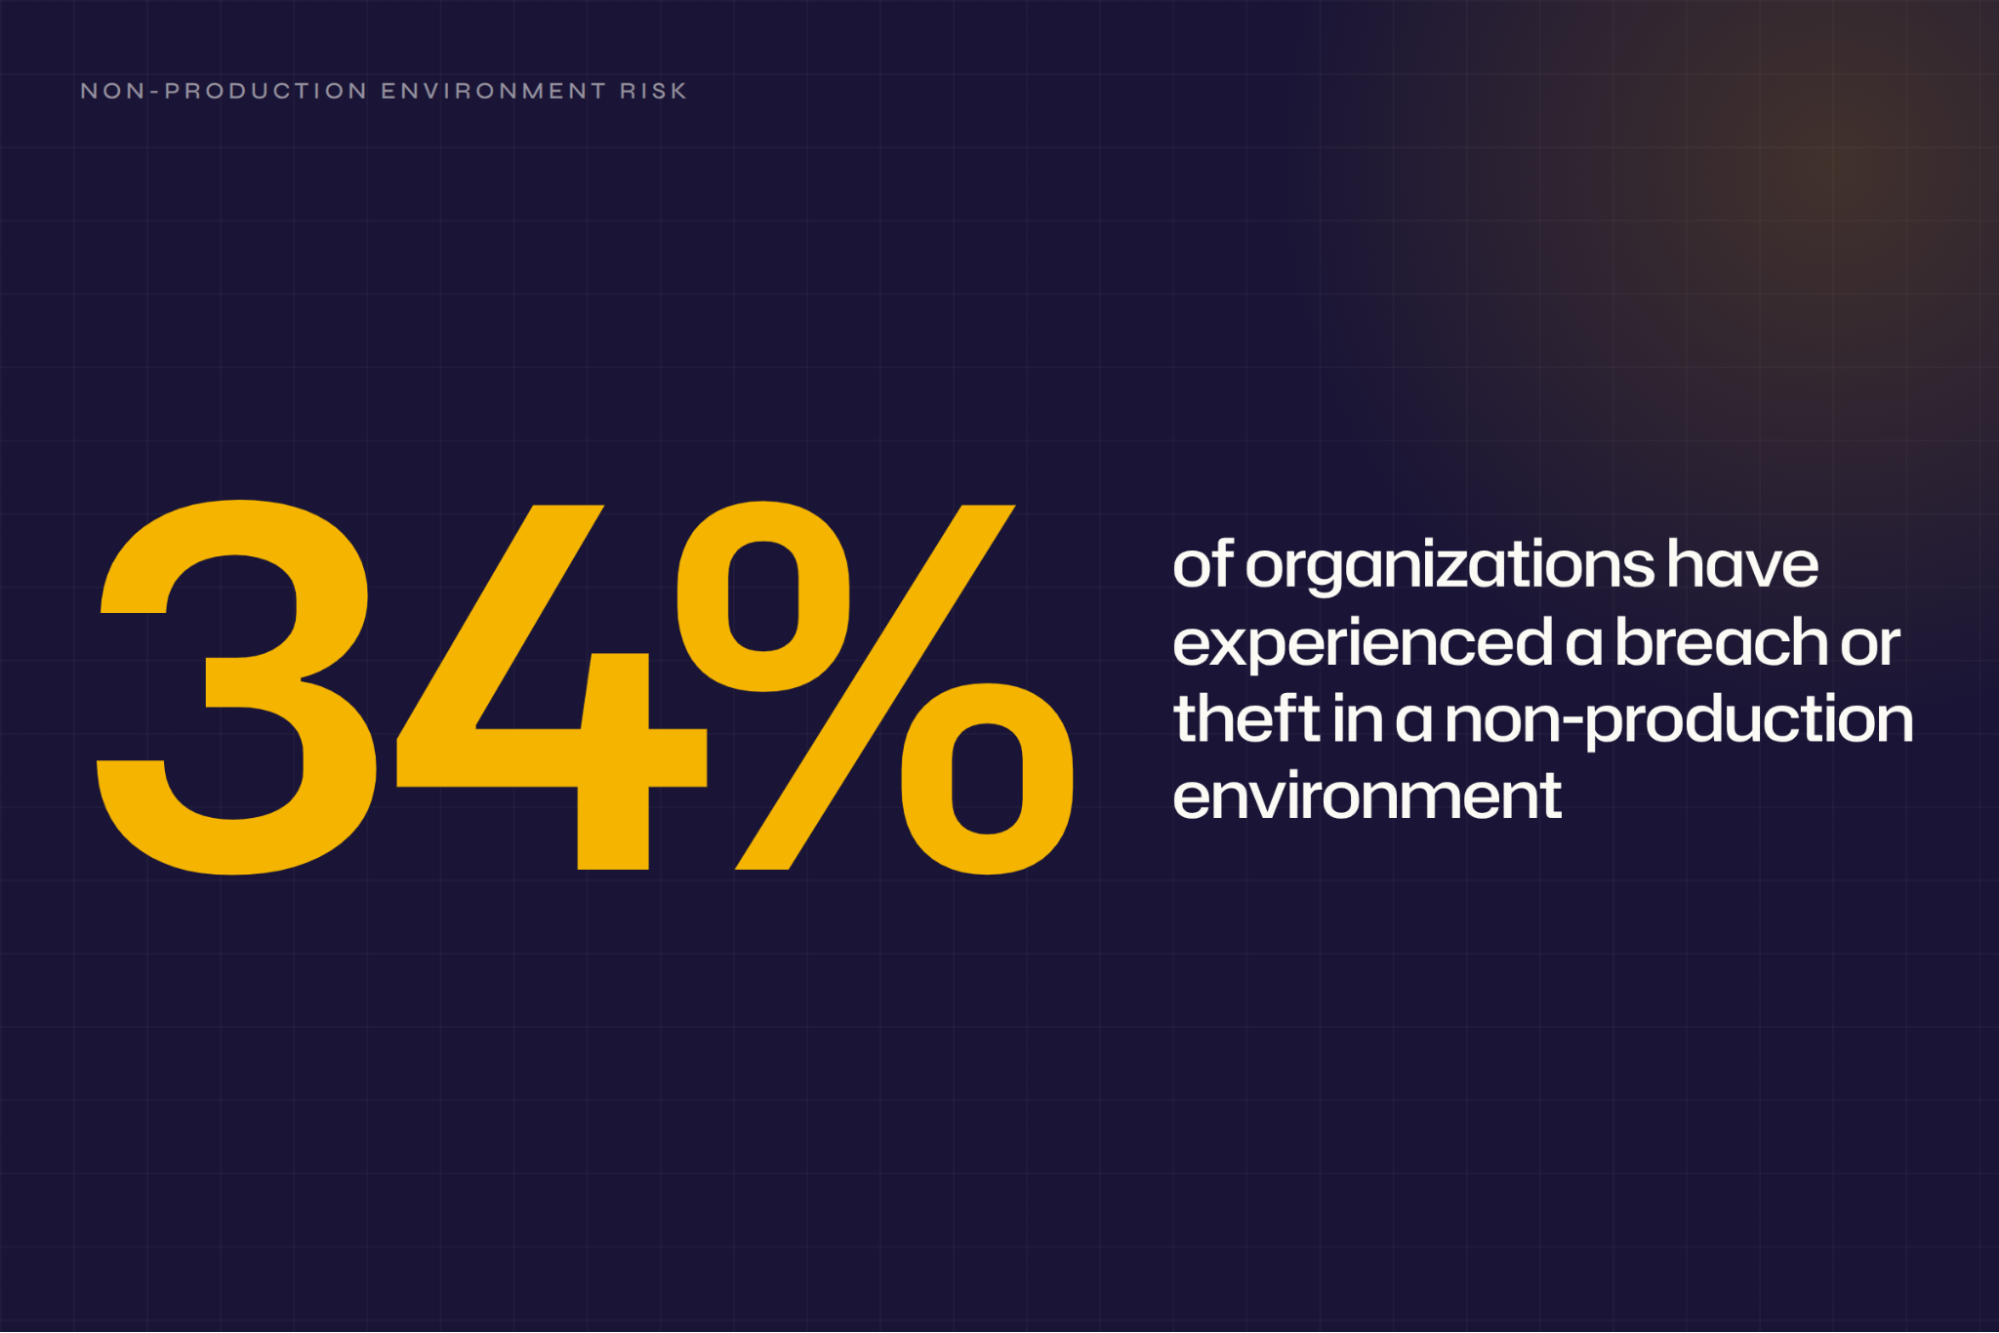
Un mandato di mascheramento dei dati esiste nel 99% delle organizzazioni, ma l’84% consente ancora eccezioni e il 34% ha subito una violazione o un furto in un ambiente non di produzione, secondo il Rapporto sullo Stato della Conformità e Sicurezza dei Dati 2026 di Perforce Delphix.
Questa distanza tra politica e pratica indebolisce controlli altrimenti validi, perché un requisito formale soddisfatto solo sulla carta non garantisce che la tecnica scelta protegga i dati.
I dati mascherati possono comunque rivelare informazioni sensibili tramite il contesto circostante. Un utente con accesso alle query può dedurre i valori sottostanti dietro una maschera dinamica confrontando i risultati di query diverse.
L'approccio giusto considera queste debolezze prima che i team creino copie in ambienti inferiori o espongano viste di produzione mascherate, iniziando dall'abbinare il tipo e la tecnica di mascheramento a ciò che ogni campo deve fare una volta uscito dalla produzione.
Cos'è la mascheratura dei dati?
La mascheratura dei dati è una tecnica di protezione che sostituisce i valori sensibili con sostituti realistici e non sensibili, così i dati restano utilizzabili senza esporre i valori reali. Un campo mascherato mantiene il formato e il tipo di dato, quindi un numero di previdenza sociale mascherato supera ancora il controllo di validità a nove cifre e uno stipendio mascherato si comporta come un numero che un report può sommare.
Quella combinazione, un sostituto che assomiglia e si comporta come l’originale senza rivelarne l’identità, permette a sviluppo, analisi e supporto di lavorare con dati di qualità produttiva senza l’esposizione del dato reale.
La mascheratura si differenzia dalla crittografia dei dati, che chiunque abbia il segreto di decrittazione può invertire, e dalla redazione dei dati, che elimina completamente il valore e lascia i tester senza un sostituto utilizzabile.
Perché è importante la mascheratura dei dati?
La mascheratura supporta diversi obiettivi operativi e di conformità quando i team la applicano ai dati e all’ambiente giusti:
- Gli ambienti non di produzione smettono di essere un problema: I team di sviluppo, test e assicurazione qualità (QA) ottengono dati realistici mentre la produzione le informazioni personali identificabili (PII) restano fuori dai dump del database.
- I programmi di conformità ottengono prove a cui fare riferimento: La mascheratura corrisponde direttamente ai controlli di pseudonimizzazione e minimizzazione dei dati già riconosciuti dagli auditor nelle principali normative sulla protezione dei dati e sui pagamenti.
- L'analisi e l'IA si muovono più velocemente: Analisti e modelli apprendono da schemi realistici mentre i dati identificabili restano protetti.
- Gli ambienti a bassa fiducia hanno un raggio d’azione minore: Se qualcuno accede al sistema di test di un fornitore o al cluster QA di un’organizzazione, i dati correttamente mascherati non offrono nulla di reale da prendere.
- I team di supporto risolvono problemi senza toccare i record originali: Un operatore help desk può riprodurre il problema del cliente su una copia mascherata invece di accedere all'account reale.
Quali sono i tipi di mascheramento dei dati?
La mascheratura dei dati assume forme diverse a seconda di quando e dove avviene. Scegliere il tipo giusto determina chi vede il valore non mascherato e quante copie mascherate dei dati si diffondono nell’ambiente.
Mascheramento statico dei dati
La mascheratura statica è il default per tutto ciò che il tuo team consegna. Prelevi una copia dalla produzione, la mascheri permanentemente e la invii a sviluppo, test o QA. Il risultato è irreversibile, poiché non puoi recuperare i valori originali dalla copia e non esiste una chiave di decrittazione da proteggere.
Microsoft ha presentato una anteprima della mascheratura statica dei dati in SQL Server Management Studio (SSMS) 18 nel 2018, per poi rimuoverla prima della disponibilità generale (GA). Un dipendente Microsoft ha confermato in una risposta nella Tech Community di febbraio 2023 che non è prevista nella roadmap.
La tecnica di base rimane standard nella maggior parte delle catene di strumenti di estrazione, trasformazione e caricamento (ETL) e migrazione di database, indipendentemente dal supporto nativo di ogni singolo fornitore.
Il problema più difficile è l'integrità referenziale, poiché mascherare un ID cliente in una tabella richiede di assegnare lo stesso valore sostitutivo a tutte le altre tabelle che si collegano, altrimenti le join si rompono senza avviso.
Mascheramento dinamico dei dati
Il mascheramento dinamico dei dati (DDM) supporta ambienti in cui i team devono interrogare direttamente il dataset di produzione invece di lavorare su una copia separata. Maschera i valori sensibili nei risultati delle query per utenti non privilegiati, lasciando intatti i dati memorizzati.
Un addetto al supporto che interroga la produzione vede XXXX dove si trova il numero di previdenza sociale (SSN), mentre un amministratore con privilegi elevati vede il valore reale. Questo approccio mantiene una copia di produzione sicura invece di una mascherata separata, ma chiunque abbia ruoli elevati nel database, e chi può costruire una query sufficientemente ristretta, ottiene comunque il valore originale.
Una query come WHERE Salary > 99999 and Salary < 100001 conferma uno stipendio mascherato senza mai mostrare la maschera, motivo per cui DDM è adatto a esposizioni accidentali più che a un attaccante determinato.
Impedisce a una query casuale di restituire un valore non previsto, ma nulla impedisce a chi restringe intenzionalmente la query finché la maschera non rivela comunque la risposta.
Netwrix DSPM individua e protegge i dati sensibili in ambienti on-premises, ibridi e cloud. Richiedi una demo.
Mascheramento istantaneo e deterministico
La mascheratura al volo, detta anche mascheratura in-flight, viene eseguita all’interno di un processo di migrazione o ETL (estrazione, trasformazione e caricamento) che legge dalla sorgente e scrive solo valori mascherati nel target, così ogni copia temporanea contiene valori protetti. Queste pipeline richiedono una pianificazione della capacità per grandi volumi.
La mascheratura deterministica associa sempre lo stesso input allo stesso output, tra tabelle, database e processi, mantenendo funzionanti join e relazioni referenziali.
Tecniche di mascheramento dei dati
I team dovrebbero scegliere solo le tecniche necessarie ai loro flussi di lavoro. Abbina ogni tecnica a ciò che il campo fa dopo la produzione.
Sostituzione
La sostituzione scambia un valore reale con uno falso realistico preso da una tabella di ricerca o dizionario. Può anche funzionare in modo deterministico, assegnando lo stesso valore falso allo stesso ID cliente ogni volta che appare, così le unioni tra database HR, paghe e benefit continuano a funzionare.
Quella tabella di ricerca è anche il punto debole. Se viene compromessa, espone l'intera mappatura originale-mascherata, e la guida OWASP indica che conservare segreti crittografici o dati di mappatura insieme a dati pseudonimizzati è un modello insicuro.
Usa la sostituzione nei dataset di sviluppo e QA quando i tester necessitano di nomi, indirizzi e numeri di conto che sembrino e si comportino come quelli reali, poiché la convalida del formato, il rendering dell'interfaccia utente e le join tra tabelle funzionano ancora.
Mescolando
Lo shuffling riorganizza i valori delle colonne in modo che ogni riga riceva il valore di un'altra riga. Oracle Data Safe osserva che lo shuffling preserva la distribuzione complessiva dei dati della colonna, e la variante group shuffle di Oracle mantiene gli scambi all'interno di una categoria, come gli stipendi in una stessa categoria lavorativa. Ogni valore reale resta nel dataset ma in una riga diversa, quindi i team devono decidere se questo garantisce sufficiente protezione.
Se identificatori quasi-correlati come CAP, data di nascita e genere restano non mescolati o vengono mescolati separatamente, qualcuno può ricollegare le righe. Mescolali insieme e riserva la tecnica per dataset analitici dove conta più la distribuzione di una colonna che quale record contiene ogni valore.
Redazione e annullamento
La redazione rimuove o cancella completamente un valore. La maschera predefinita di SQL Server, ad esempio, trasforma le stringhe in XXXX e i numeri in 0. Una maschera predefinita è facile da configurare, ma distrugge l’utilità del campo per test o analisi. Usala solo per campi senza scopi a valle in un ambiente inferiore, come un SSN completo, un numero di carta completo o una colonna di note a testo libero che nessuno deve vedere.
Tokenizzazione e crittografia che preserva il formato
La tokenizzazione sostituisce un numero di conto primario (PAN) con un token surrogato, mentre la crittografia che preserva il formato (FPE) mantiene il formato e la lunghezza del testo cifrato. Entrambi sono reversibili per progettazione, il che modifica il modello di rischio. I token basati su vault si basano su una ricerca; i token senza vault derivano crittograficamente dal PAN, quindi il sistema memorizza solo un segreto crittografico.
Chiunque detenga il segreto crittografico o la cassaforte può recuperare ogni valore protetto, quindi gestire questi segreti e cassaforti determina il rischio residuo, e PCI SSC avverte che compromettere la cassaforte dei dati potrebbe compromettere l'intero sistema di tokenizzazione.
Scegli la tokenizzazione o FPE quando i dati di pagamento e finanziari devono mantenere il formato originale o rimanere reversibili per un flusso autorizzato; segmentare un sistema solo token dall'ambiente di tokenizzazione può persino spostarlo fuori dal campo PCI DSS dei dati del titolare della carta.
Aggiunta di rumore e varianza
L'aggiunta di rumore somma o moltiplica una quantità casuale a un valore numerico in modo che il totale rimanga invariato mentre i singoli dati si sfumano. La variazione numerica in Informatica, azienda Salesforce, funziona così.
Documenti Informatica per cui un input di 66 con una varianza simmetrica del 50% si colloca tra 33 e 99. Usa l'aggiunta di rumore in report e addestramento modelli quando la tendenza o distribuzione conta più di un singolo record, come fasce salariali, coorti di età e importi delle transazioni.
Dove la mascheratura dei dati non basta
La mascheratura riduce l’esposizione, ma non è una risposta completa al rischio dati da sola. Ogni limitazione qui sotto determina quanto controllo aggiuntivo serve ancora a un programma di mascheratura, da cosa succede quando qualcuno unisce i dati mascherati ad altro fino a se i regolatori considerano sicuro il risultato.
Rischio di re-identificazione quando i dataset sono combinati
Chiunque possieda un secondo set di dati può smascherare dati mascherati unendoli. Combinazioni come CAP, sesso e data di nascita possono distinguere individui se un attaccante ha dati ausiliari adeguati.
Un preprint su arXiv di febbraio 2026, Deanonimizzazione online su larga scala con LLM, ha riportato fino al 68% di richiamo con il 90% di precisione per la re-identificazione basata su LLM di utenti online pseudonimi, contro quasi lo 0% per il miglior metodo non LLM.
Lo studio ha riguardato profili online anziché tabelle mascherate, ma il meccanismo è lo stesso: attributi residui confrontati con dati esterni.
Non protegge i dati originali a riposo
La mascheratura crea una copia sicura o una vista sicura. Il sistema di produzione che contiene i valori reali necessita comunque dei propri controlli di accesso, crittografia e visibilità.
Alcune tecniche sono forti solo quanto il loro anello più debole
Una tabella di ricerca, un deposito di token o uno schema di hashing possono esporre tutte le corrispondenze contemporaneamente. Set di input piccoli o prevedibili permettono agli attaccanti di testare valori finché non riproducono un hash memorizzato. La guida della Federal Trade Commission (FTC) di luglio 2024 si intitola "No, l'hashing non rende ancora anonimi i tuoi dati."
Le autorità non considerano i dati mascherati automaticamente sicuri
Secondo le norme di pseudonimizzazione del GDPR, i dati pseudonimizzati restano dati personali. Il considerando 26 dello stesso regolamento copre qualsiasi dato che si possa attribuire a una persona tramite informazioni aggiuntive, e le Linee guida 01/2025 dell'EDPB affermano che la pseudonimizzazione necessita sempre di ulteriori misure.
Il 4 settembre 2025, la Corte di Giustizia dell'Unione Europea (CGUE) ha deciso in EDPS contro SRB (C-413/23 P) che i dati pseudonimizzati possono non essere considerati dati personali per un destinatario che non può reidentificare gli individui, ma restano gli obblighi del titolare, incluso informare gli interessati su chi riceve i loro dati.
Secondo HIPAA, l'Ufficio per i Diritti Civili del Dipartimento della Salute e dei Servizi Umani degli Stati Uniti (HHS OCR) richiede Determinazione Esperta o Safe Harbor.
Come decidere se la mascheratura è sufficiente per i tuoi dati
La vera decisione riguarda quale tipo, quale tecnica, per quali dati e cos’altro la supporta. Le considerazioni seguenti esaminano l’inventario, l’uso a valle, gli obblighi normativi e i controlli di accesso che determinano se un approccio di mascheramento è difendibile.
Inizia conoscendo ciò che possiedi
Crea e mantieni un inventario aggiornato di dove i dati sensibili si trovano e di che tipo sono prima di configurare qualsiasi regola di mascheramento. Una regola di mascheramento è valida solo quanto l'inventario che indica a quali tabelle applicarla.
Il Rapporto sulla Sicurezza dei Dati e dell'Identità Netwrix 2026 ha rilevato che il 57% delle organizzazioni non mantiene tale inventario in modo continuo, e NIST CSF 2.0 lo indica come sottocategoria (ID.AM-07). Esegui la scoperta e la classificazione automatizzate su ogni database, condivisione file e archivio cloud, quindi inserisci i risultati direttamente nella configurazione di mascheramento.
Adatta la tecnica alle esigenze dei dati a valle
Traccia ogni campo sensibile fino ai suoi utilizzatori a valle, poi scegli la tecnica che mantiene quegli utilizzatori attivi. Linee guida di trasformazione Google consiglia la redazione, sostituzione o mascheramento quando l’uso a valle non necessita del valore originale o di join stabili, e la tokenizzazione crittografica quando serve. Per analisi dove sequenza e distribuzione sono importanti, applica raggruppamento dati o spostamento date. Copie di sviluppo e test che devono solo sembrare reali puntano alla sostituzione; i campi di pagamento che un processore deve convalidare puntano a tokenizzazione o FPE.
Verifica cosa richiede il tuo quadro normativo
Individua quale norma si applica al dataset prima di scegliere una tecnica, perché lo standard di pseudonimizzazione del GDPR e i requisiti di conservazione PCI DSS fissano criteri diversi.
Il requisito PCI DSS 3.5.1 accetta hash unidirezionali dell'intero PAN basati su crittografia forte, troncamento, token indice o crittografia forte con gestione sicura dei segreti. Avverte che conservare versioni troncate e hashate può permettere la ricostruzione del PAN originale.
GDPR richiede informazioni di inversione separate, come tabelle di mappatura e segreti crittografici, gestiti con controlli tecnici e organizzativi. HIPAA Safe Harbor, invece, è una lista di controllo di 18 identificatori e non richiede la consapevolezza che ciò che rimane possa identificare qualcuno, quindi non chiede mai un percorso di inversione.
Abbina la mascheratura alla governance degli accessi
Verifica chi può accedere ai dati originali e revoca gli accessi non più giustificati, quindi ripeti questa verifica a intervalli definiti. Il Rapporto Netwrix 2026 su Sicurezza dei Dati e Identità ha rilevato che il 75% delle esposizioni di dati sensibili inizia con identità compromesse o permessi configurati erroneamente.
Ecco perché solo la mascheratura non elimina il rischio, poiché l’esposizione si trova all’incrocio tra ciò che è sensibile e identità, ruoli e privilegi che possono accedervi. Collega questo lavoro di scoperta ai controlli che agiscono su di esso, come mascheratura dinamica, crittografia, tokenizzazione e governance degli accessi, quindi trovare dati sensibili non si limita a creare un inventario.
Come Netwrix ti aiuta a fare correttamente il data masking
La maggior parte del lavoro sopra, dalla creazione dell'inventario all'abbinamento delle tecniche ai quadri normativi, si applica indipendentemente dagli strumenti usati da un team. Netwrix integra la scoperta, il contesto di accesso e le prove di conformità che la maggior parte dei programmi di mascheramento ancora assemblano manualmente in un'unica piattaforma.
Sapere cosa mascherare prima di farlo
Netwrix DSPM individua e classifica i dati sensibili in ambienti ibridi, identifica accessi eccessivi o aperti e dà priorità ai rischi da correggere.
Netwrix Access Analyzer alimenta Netwrix DSPM, scoprendo e classificando i dati sensibili e analizzando chi può accedervi in oltre 40 fonti dati supportate.
Quel risultato dovrebbe guidare le decisioni di mascheramento sopra, poiché indica quali campi contengono dati sensibili e quale tecnica si adatta all’uso di ciascun campo una volta fuori produzione.
Vedere il rischio oltre il testo mascherato
Netwrix DSPM utilizza la classificazione come input e aggiunge il contesto di accesso che la mascheratura non può fornire. La classificazione indica cosa sono i dati. DSPM indica chi può accedervi e cosa correggere.
Netwrix DSPM individua accessi obsoleti, accessi aperti e permessi ad alto rischio su dati sensibili, così un programma di mascheramento gestisce chi può accedere all’originale e cosa espongono le copie.
Produzione di prove accettate dagli auditor
Netwrix Access Analyzer mappa i dati scoperti e classificati ai framework come GDPR, HIPAA e PCI DSS. Riporta anche chi ha accesso ai dati e supporta i flussi di revisione degli accessi, fornendo ai team prove dei controlli di governance sul masking.
Netwrix Auditor offre report predefiniti di conformità più ampi e tracce di audit su infrastrutture e sistemi dati.
Con Netwrix Auditor, First National Bank and Trust di Beloit si prepara per le verifiche dell'Ufficio del Controllore della Moneta (OCC) in solo un'ora, invece di una settimana.
Applica la mascheratura dei dati nella tua strategia di protezione dei dati
La mascheratura riduce l’esposizione in copie di test, estratti analitici e viste di supporto, ma solo quando tipo e tecnica si adattano all’uso di ciascun campo a valle.
Quasi tutte le organizzazioni hanno già un mandato di mascheramento; ciò che distingue un programma funzionante da una politica su carta è se quel mandato raggiunge i team dati che copiano dalla produzione ogni giorno.
Inizia con un inventario accurato, perché ogni decisione successiva su tipo, tecnica e normativa dipende dal conoscere i dati e dove risiedono, e rivedi quell'inventario ogni volta che gli schemi sottostanti cambiano.
Richiedi una demo per scoprire come Netwrix può aiutarti a individuare e classificare dati sensibili, gestire gli accessi e produrre le prove di conformità necessarie a un programma di mascheramento.
Domande frequenti sulla mascheratura dei dati
Condividi su
Scopri di più
Informazioni sull'autore

Netwrix Team
Scopri di più su questo argomento
Monitoraggio dell'attività del database: cosa osservare e come farlo
OpenAI e l'ambiente che eredita l'IA
Esempio di Analisi del Rischio: Come Valutare i Rischi
Il Triangolo CIA e la sua applicazione nel mondo reale
Analisi quantitativa del rischio: Aspettativa di perdita annuale